Multimodale Lokalisierung im Dienst der Kreativen.
Synchronisation, endlich gut.
Dieselbe Familiar-Performance für jedes Publikum.
Jedes Wort verstehen. Mit Familiar Labs bleibt die ganze Performance erhalten.
- Musik & Soundeffekte
- Publikum & Lachen
- Mehrere Sprecher
- Räumliches Denken
- Bis zu 4K
- Stereo & 5.1-Surround


▚ SONG DUBBING ▞
Ein musikalischer Durchbruch.
EMOTION. RHYTHMUS. BEWAHRT.
Die Stimme und die Lippen des Sängers selbst, übertragen in eine andere Sprache. Veröffentliche dein Album weltweit.
Spanisch → Englisch | ein Ausschnitt von zwei Minuten
Will Smith, Beautiful Scars | ins Spanische synchronisiert
THE RED PILL
VERSE 1 | WILL SMITH
CHORUS | OBANGA & BIG SEAN
VERSE 2 | BIG SEAN
CHORUS | OBANGA & BIG SEAN
VERSE 3 | WILL SMITH
CHORUS | OBANGA
- 01 / 03 | Bei 0:13
Zähne und Lippen, gleich dreifach
In diesem Bild sprechen zwei Menschen: Lippen und Zähne folgen dem Spanischen im Gesicht und bei beiden Spiegelungen von Will in der Brille.
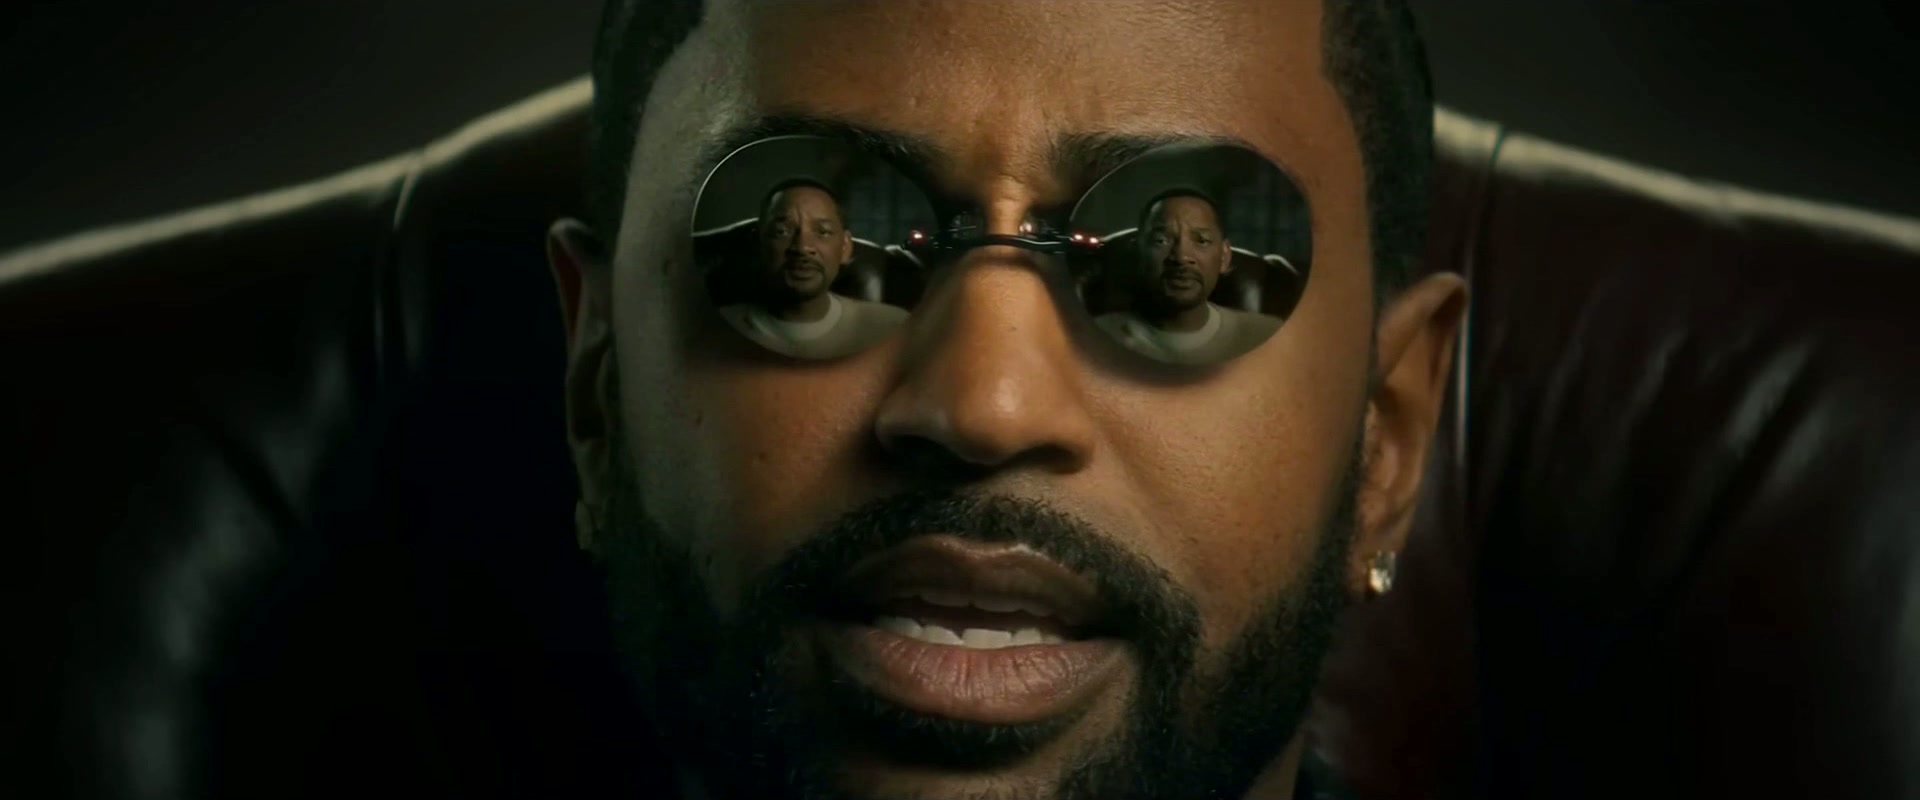 Synchro | Stimme und Lippen ins Spanische übersetzt
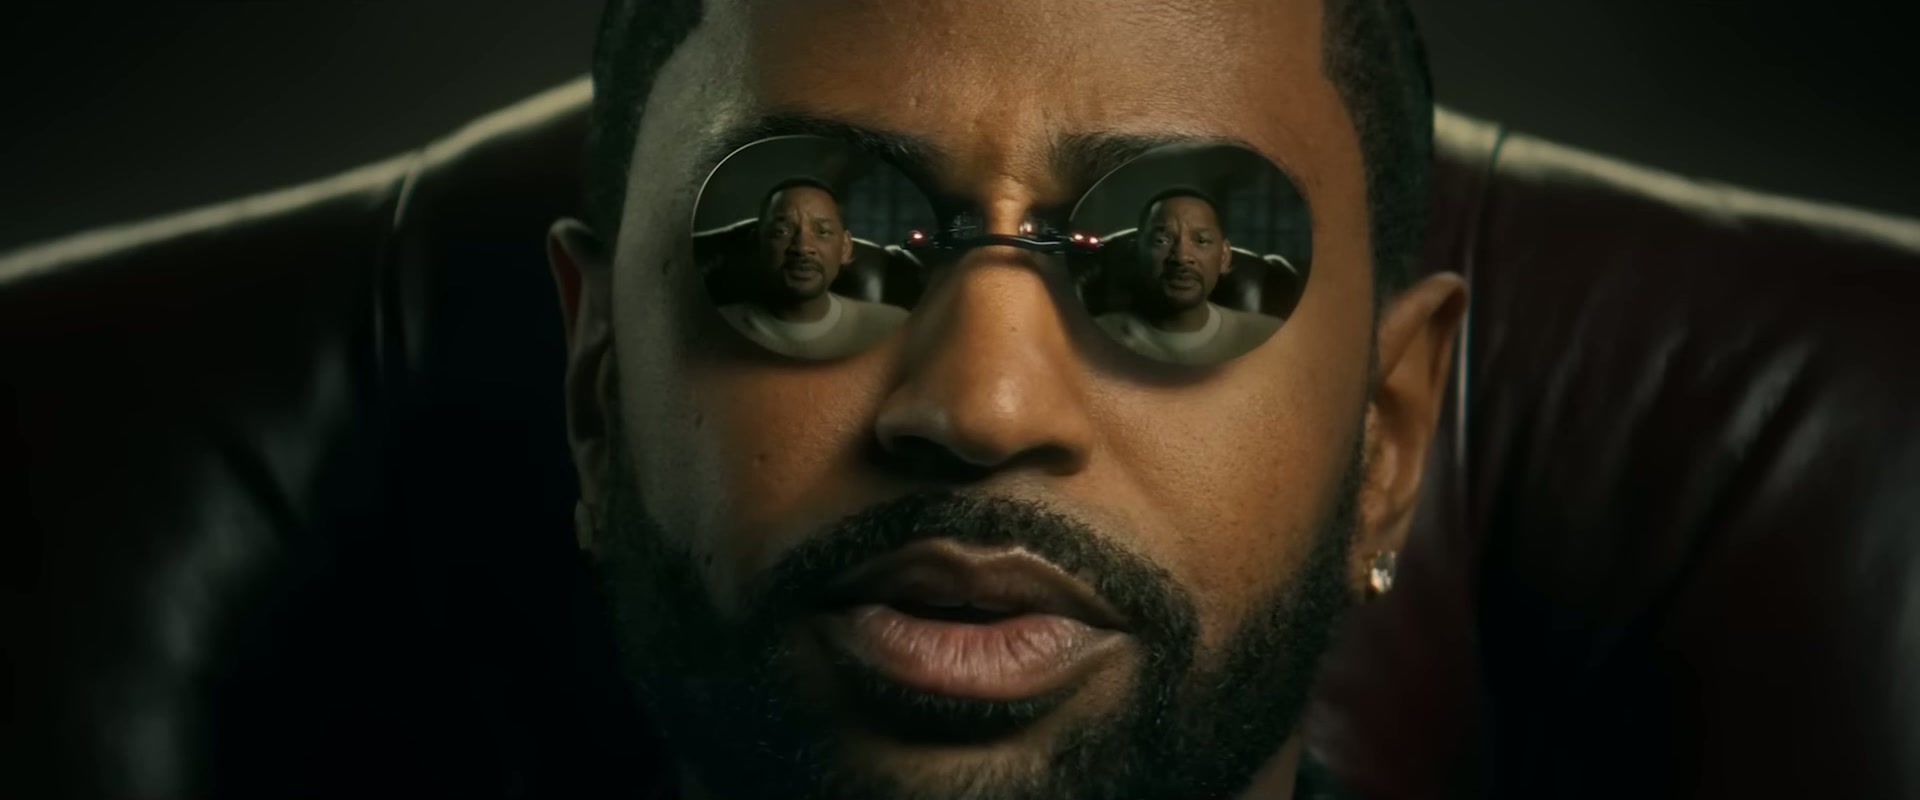 Original | Englisch, dasselbe Bild
- 02 / 03 | Bei 2:30
Räumliches Denken durchs Fischauge
Das Objektiv verzerrt das ganze Gesicht, eine Hand verdeckt das dahinter; die Synchro hält.
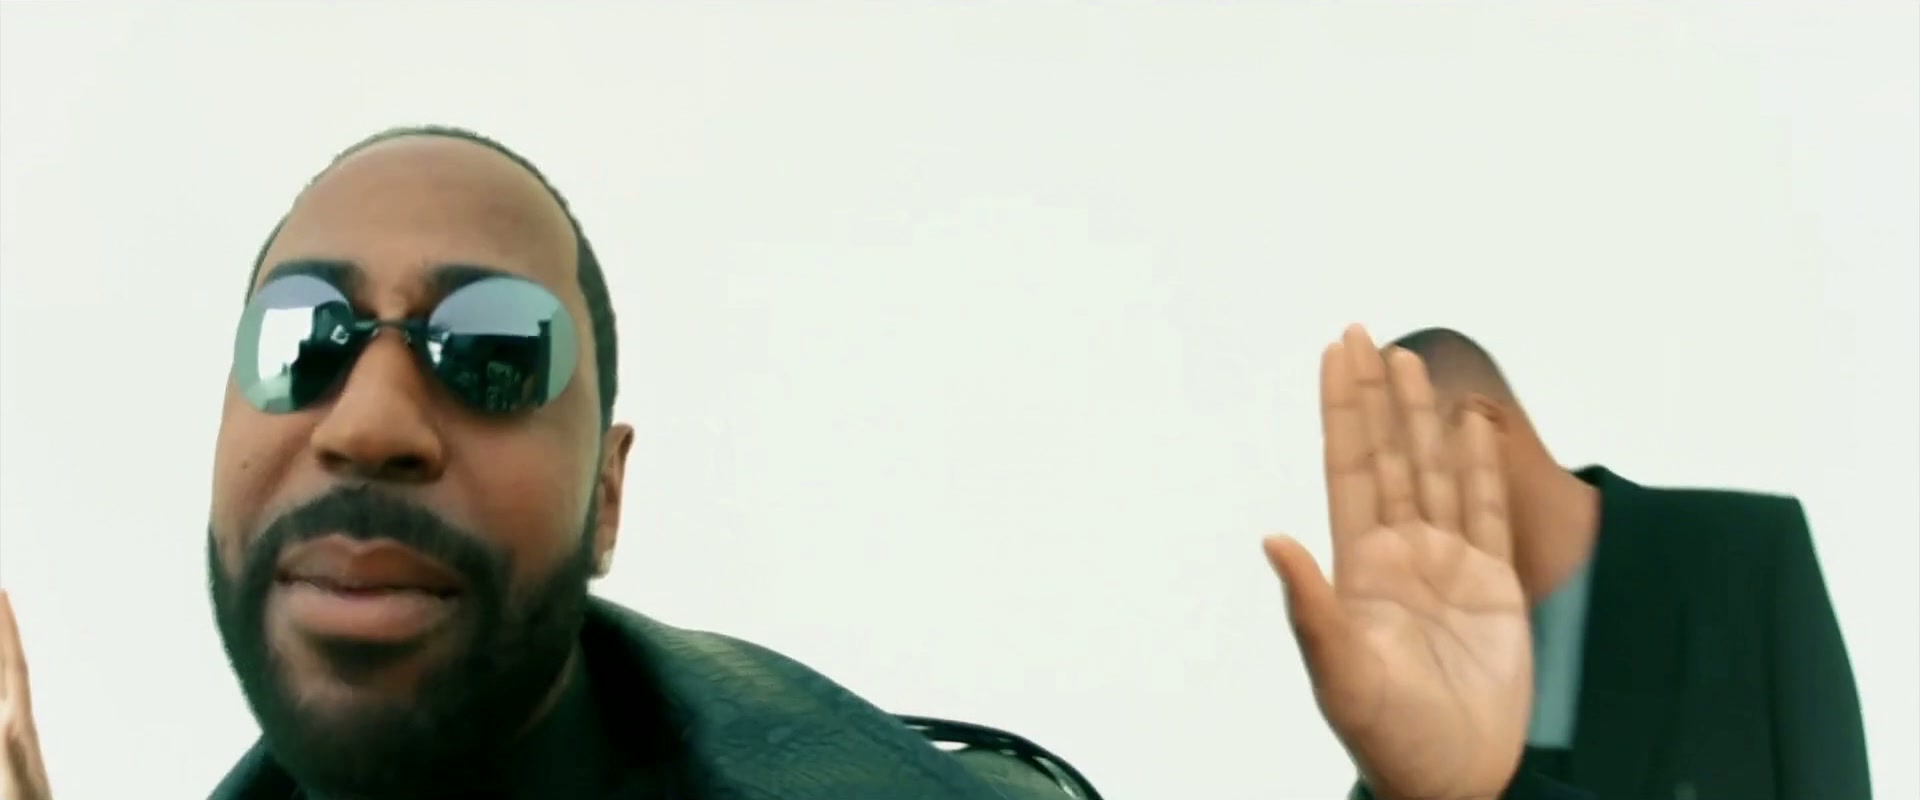 Synchro | Stimme und Lippen ins Spanische übersetzt
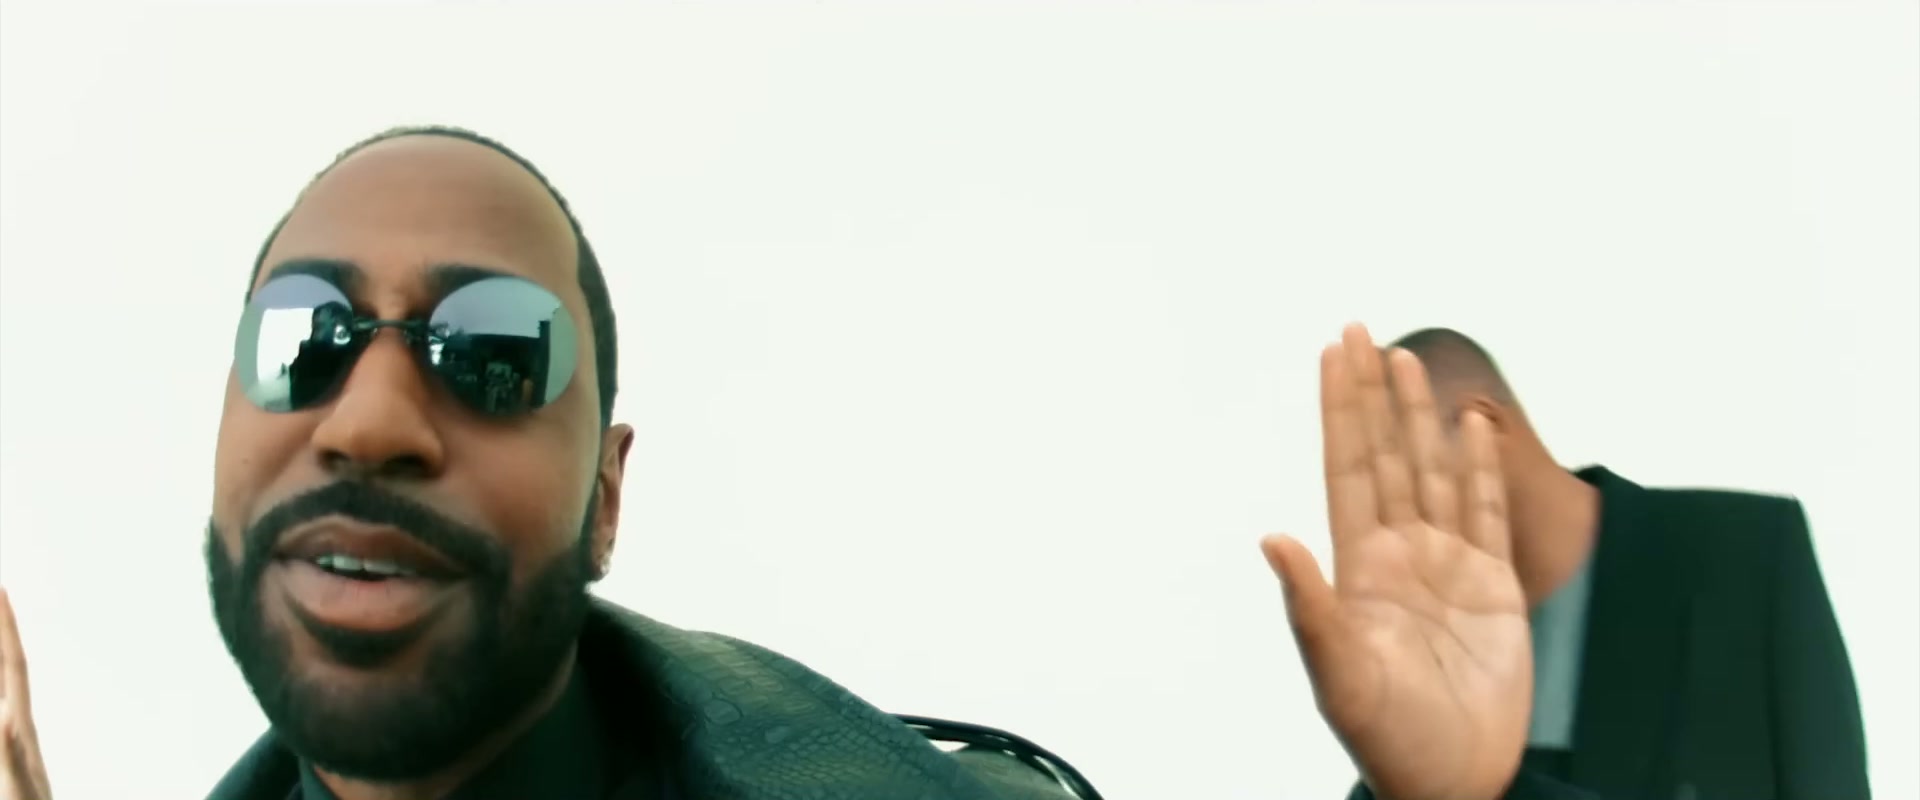 Original | Englisch, dasselbe Bild
- 03 / 03 | Bei 3:40
Dieselbe Bewegungsunschärfe
Ein Reißschwenk mitten in der Zeile: Der Mund hat dieselbe Unschärfe wie der Rest der Einstellung.
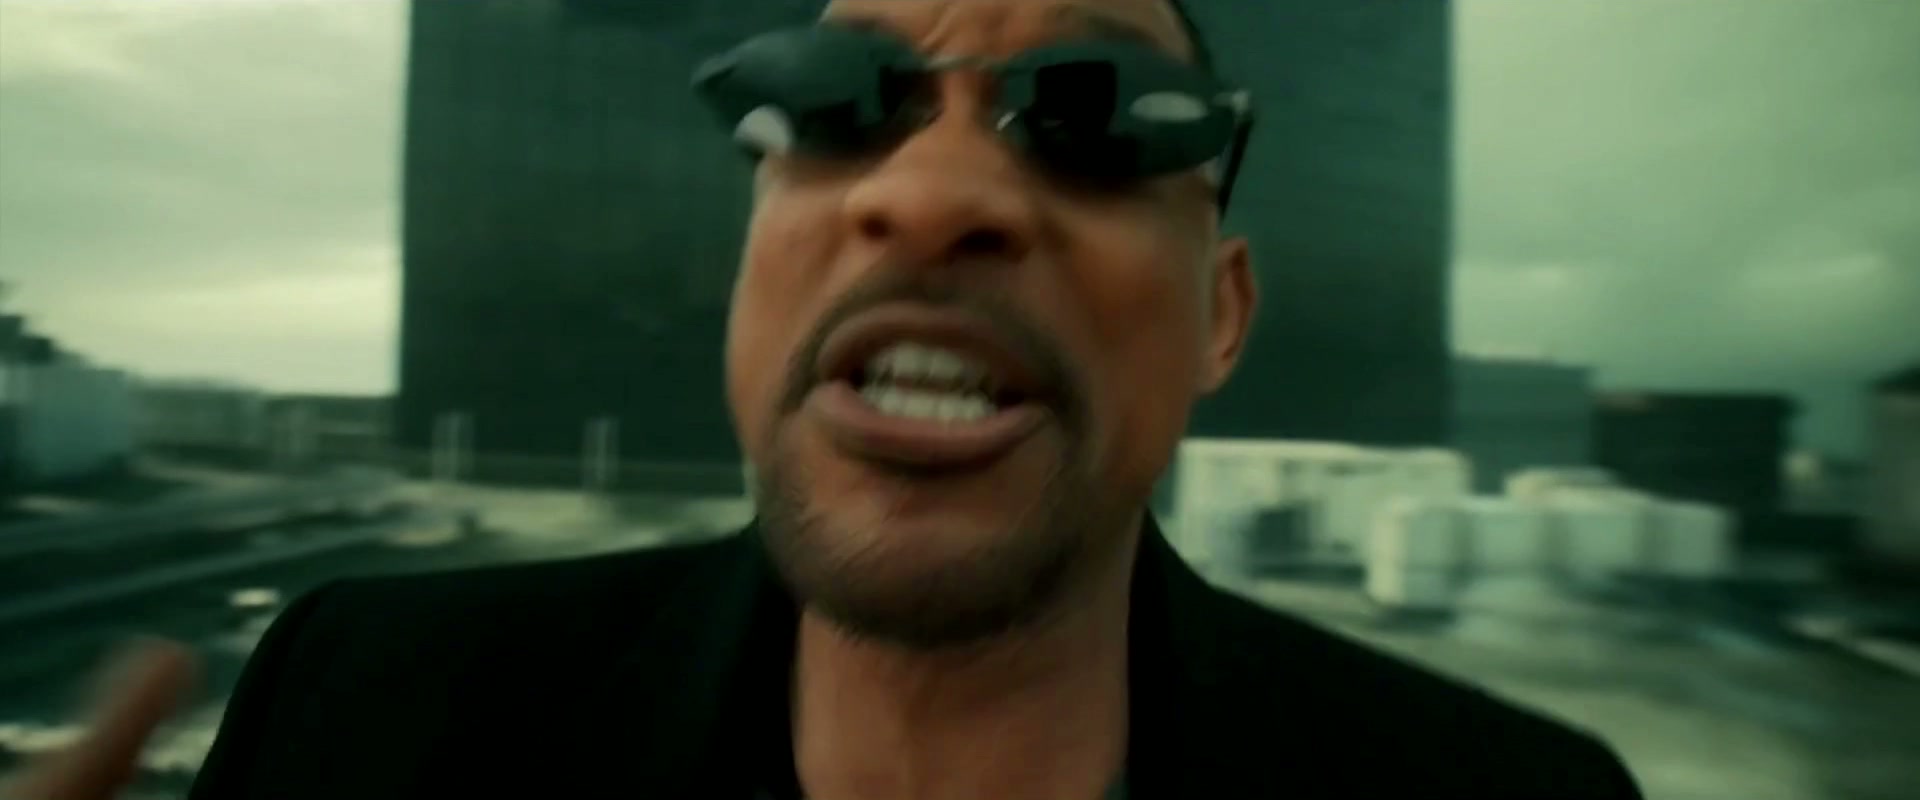 Synchro | Stimme und Lippen ins Spanische übersetzt
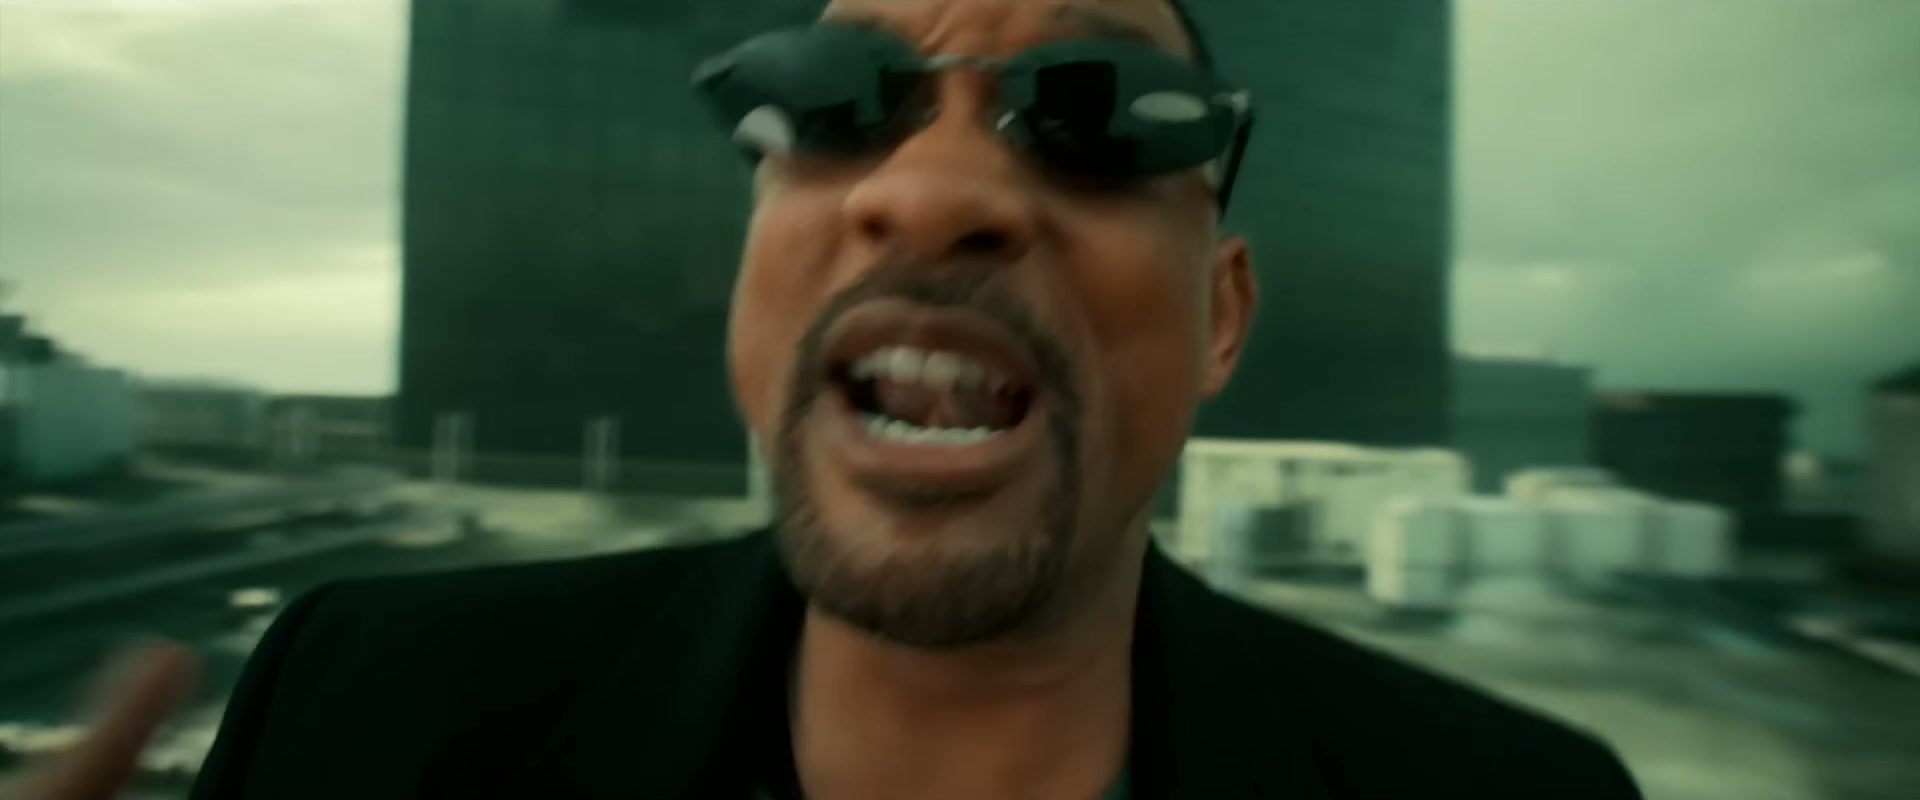 Original | Englisch, dasselbe Bild
Die Performance bleibt so vollständig erhalten, dass sogar Songs in einer anderen Sprache funktionieren.
 Jibin SongChief ScientistTEAM →
Deshalb werden auch die Songs lokalisiert, wo immer sie vorkommen:
- Animationsfilme
- Kinderinhalte
- Musicals
- Songs in Filmen und Serien
- Titelsongs und Intros
- Alben und Musikvideos
MEHR UMSATZ & REICHWEITE.
 65%Nur kein Wort über Bruno | Lateinamerikanisches SpanischAllein eine synchronisierte Fassung kam auf 426 Mio. Aufrufe, 65% der 656 Mio. des englischen Originals.
 1,13 Mrd.Ich bin bereit | Brasilianisches PortugiesischSo oft wurde die brasilianische Fassung auf YouTube aufgerufen, neben 1,54 Mrd. Aufrufen für das englische Original.
 41Lass jetzt los | SprachenDas meistverkaufte Album 2014. In Japan kam die japanische Fassung auf Platz 2 und wurde für eine Million Verkäufe ausgezeichnet.
 66%Pushpa 2 | HindiDer Anteil der Hindi-Synchronfassung am Einspielergebnis des Films in Indien; das Original auf Telugu kam auf 27%.
Jeder dieser Songs wurde von einem Sänger vor Ort neu eingesungen. Mit Song Dubbing geht die Original-Performance selbst um die Welt.
Für Plattenlabels: Kontakt aufnehmen →23×
mehr gestreamte Minuten, wenn ein Titel visuell synchronisiert ist.
GEGENÜBER DER REINEN TON-SYNCHRONISATION DESSELBEN TITELS
DIE GRENZE MENSCHLICHER SYNCHRONISATION
- Verlust der Performance
- Schwer skalierbar
- Teuer
- Heutige KI greift zu kurz
▚ EIN DURCHGANG, NICHT WOCHEN ▞
Erst die Übersetzung, dann die Synchronisation in einem Durchgang:
 Familiar Labs
 Flawless
 HeyGen
 ElevenLabsFamiliar LabsFlawlessHeyGenElevenLabs
Die assistiven Tools, mit denen die Branche heute arbeitet, brauchen ein Team aus VFX-Artists und Wochen pro Projekt, und jede Sprache ist ein neues Projekt.
Die Tools, die heute in einem Durchgang arbeiten, opfern den Rest: Die Übersetzung lässt sich nicht bearbeiten, Musik und Raumklang fallen weg, die Stimme driftet ab, und die Lippen versagen bei einer Hand vorm Gesicht, einem Mikrofon, Unschärfe, Bokeh, einer Seitenansicht oder mehreren Personen im Bild. Kein räumliches Denken, kein Weltverständnis, keine Kontrolle.
Familiar Labs vs. Flawless TrueSync →UNTERSTÜTZT VON


 Stanford
 Yonsei

Keine „generative KI“, sondern Übersetzung im Dienst der Kreativen.
Von Mensch zu Mensch, nicht von KI zu KI →„Generative KI ist der Bereich der künstlichen Intelligenz, der auf Prompts von Nutzern hin originäre Inhalte erstellt, etwa Texte, Bilder, Videos, Audio und Software-Code.“

MLFM für die Fleißarbeit.
Keine Prompts. Nichts Neues wird zufällig erzeugt.
Von Mensch zu Mensch, mit größerer Reichweite.
Alle Daten, mit denen wir trainiert haben, hat das Team von Familiar Labs selbst erstellt.

Multimodales Foundation Model für die Lokalisierung.
Ein neues Paradigma, das erste seiner Art.
Ein Modell, das entscheidet, was lokalisiert wird und wie, über Text, Ton und Bild hinweg, und dir die Optionen vorlegt, auf die es ankommt.

Welche Fassung eines Satzes.
- Mehrere Fassungen abgewogen; deine Creative Directors sehen sie samt Begründung und entscheiden.
- Was unübersetzt bleibt: der Slang, wie er gesagt wurde, der Name und die Marke.
- Eine Anspielung, die das Publikum kennt; was die Kultur meidet, bleibt draußen; entschärfte Kraftausdrücke für eine jüngere Fassung.
Was überhaupt übersetzt wird.
- Die Hauptstimme gefunden und getragen, in der eigenen Stimme des Sprechers.
- Das Lachen, die Menge, ein Ruf, jemand, den niemand versteht: Alles bleibt, wie es war.
- Ein Sprechchor, ein Schrei, eine Redewendung, in der Originalsprache belassen.
Was im Bild lokalisiert wird.
- Wer es tatsächlich sagt: wer erzählt, wer aus dem Off spricht.
- Die Lippen, samt Verdeckungen und räumlichem Denken.
- Mimik und Gesten, wenn die Betonung oder die Kultur es verlangt.
- Der Text im Bild (ein Handydisplay, ein Buchcover, ein Straßenschild, ein Schaufenster), mit den Begriffen, die du schon festgelegt hast.
- Was so bleibt, wie es gedreht wurde, von selbst entschieden: Eine Tüte Tostitos bleibt Tostitos.
- Zu welchem Gesicht ein Satz gehört und welcher Text übersetzt wird.
Jede Entscheidung wird mit dem Auftrag festgehalten. Du kannst jede davon überschreiben, und eine einmal getroffene Wahl gilt auch für die nächste Folge.
Was ist MLFM?▚ AUF DENSELBEN CLIPS GETESTET ▞
Benchmarks
Verdeckungen und räumliches Denken: Mikrofone direkt vorm Mund, Hände vorm Gesicht, und die Synchro hält.

▚ DIE API ▞
Deine Plattform in jeder Sprache.
review=manualCreative Directors prüfen, bevor es rausgeht.
- Zeilen mit mehr als einer Lesart, etwa ein Witz oder eine Spitze, kommen als drei Übersetzungen mit eigener Absicht und Emotion zurück.
- Deine Creative Directors wählen eine aus.
- Dann bearbeiten sie bei Bedarf jede Zeile mit Blick aufs Original und stoßen die Synchro an.
- 1Apples. I'm sorry, right down to the core.Wortspiel · verlegen
- 2I came to say sorry. I brought apples.Sinngemäß · aufrichtig
- 3An apple a day keeps the silent treatment away.Neuer Witz · verspielt
- 1Wow. You're incredible.Aufrichtig · herzlich
- 2Well, aren't you something.Sarkastisch · trocken
- 3Look at you, hotshot.Neckend · verspielt
/v1/dubs/dub_31xk9m/render- ÜBERSETZUNG00:12.4seg_12 · 사과하려고 사과 사 왔어.Apples. I'm sorry, right down to the core.I came to say sorry. I brought apples.An apple a day keeps the silent treatment away.Wahl des Creative DirectorsEDITED
- TON00:41.2 – 00:44.0Crowd chantKeep in KoreanTranslateÜberschreiben
- BILD00:58.0Phone screen · 내일 봐See you tomorrowKeep as shotÜberschreiben
- BILD01:12.6SpeakerSpeaker 1Speaker 2Speaker 3Überschreiben
/v1/dubs/dub_31xk9m/decisions/GET /v1/dubs/{dub_id}/decisionsDas Entscheidungsprotokoll: nachlesen und überschreiben.
Deine Creative Directors sehen die Übersetzungsfassungen schon heute samt Begründung. Die Entscheidungen zu Ton und Bild sind in Arbeit: ein Sprechchor im Original, welchem Gesicht eine Zeile gehört, der Text auf einem Handydisplay.
Zur Dokumentation →Private Inferenz: unsere eigenen GPUs in Toronto, nie eine Public Cloud.
Jede Synchro wird auf unserem eigenen Cluster im achtstelligen Dollarbereich verarbeitet: NVIDIA B300, die besten GPUs auf dem Markt, in Toronto, Kanada. Deine Medien werden nie in einer Public Cloud wie Google Cloud oder AWS verarbeitet und nie bei einem fremden Inferenzanbieter. So gelangt nichts nach außen.
Zur Dokumentation →- GPUS
- NVIDIA B300, the best on the market
- CLUSTER
- Eight figures, USD
- LOCATION
- Toronto, Canada
- OPERATOR
- Familiar Labs, on compute we own
- PUBLIC CLOUD
- None
- THIRD-PARTY INFERENCE
- None
Nur für Unternehmen: ein Studio-Vertrag mit Volumenpreisen und dediziertem 24/7-Support.
▚ SPRACHEN ▞
13 Sprachen, jede zu jeder.
Erreiche jedes Publikum, mit der eigenen Stimme und den eigenen Lippen.
AUSGANGS- UND ZIELSPRACHEN13
- Arabisch
- Chinesisch
- Deutsch
- Englisch
- Französisch (Frankreich)
- Hindi
- Italienisch
- Japanisch
- Koreanisch
- Portugiesisch (Brasilien)
- Russisch
- Spanisch (Lateinamerika)
- Thailändisch
▚ SICHERHEIT ▞
Versiegelt auf deinem Rechner. Geöffnet nur in Toronto.
Deine Inhalte werden nie zum Training verwendet.
VERSIEGELTER UPLOAD
Verschlüsselt auf deinem Rechner, bevor etwas dein Netzwerk verlässt, sodass eine bei der Übertragung abgefangene Datei unlesbar ist; die fertige Synchro kommt genauso versiegelt zurück.
EIGENE SERVER IN TORONTO
Verarbeitet und gespeichert auf eigener Rechenleistung in Toronto, Kanada; keine Public Cloud, kein fremder Inferenzanbieter.
MINIMALE RECHTE
Die Schlüssel zum Entschlüsseln verwahren zwei benannte Verantwortliche; außerhalb unserer benannten Sicherheitsrollen kann niemand deine Inhalte öffnen.
PLANMÄSSIG GELÖSCHT
Gelöscht, sobald die Synchro zurückgeschickt ist (Zero Data Retention), nach deiner Abnahme oder automatisch 14 Tage nach der Lieferung.
TPN+-MITGLIED | MPA CONTENT SECURITY BEST PRACTICES
Für Aufträge von Studios, Streamingdiensten und Labels unter Vertrag.

Fragen?
Synchronisation einer neuen Generation: deine Stimme und deine Lippen, übertragen in neue Sprachen; wer ElevenLabs und HeyGen zusammenflickt, klingt und wirkt trotzdem wie ein Fremder. Und das ist mehr als KI-Lippensynchronisation: Das ganze Gesicht spricht die neue Sprache, samt Verdeckungen und räumlichem Denken.
In unserem veröffentlichten Benchmark:
- ihr neuestes Produkt hatte 270% mehr Fehler bei den Hintergrundgeräuschen: das Lachen, die Musik, die Atmosphäre
- 54.7% weniger schwerwiegende Übersetzungsfehler als ihr neuestes Produkt
- gegenüber ihrem Dubbing v1 klang unsere Stimme 27.8% mehr nach dem echten Sprecher, in allen 11 Sprachen näher dran
Bei denselben Clips hat ElevenLabs:
- 45-mal Wörter verschluckt oder erfunden
- 8-mal Lachen und Soundeffekte zerstört
- 6-mal die Stimme des Sprechers verloren
- 6-mal überlappende Sprecher vermischt
- 4-mal die Vortragsweise glattgebügelt
- 4-mal die Atmosphäre der Szene entfernt
- seine API lehnt Clips unter 11 Sekunden ab
Wer sich das selbst zusammenflickt, zahlt $11 pro Minute: $8 für den Lipsync von Sync.so plus $3 für das Audio von ElevenLabs. Eine Synchro von Familiar Labs enthält Stimme, Lipsync und Übersetzung, in bis zu 4K mit echtem 5.1-Surround- oder Stereo-Mix.