TEAM
PhDs & Forscher
 Stanford
 Yonsei

Wir existieren, um jede Verständigungsbarriere zu durchbrechen.
Stell dir eine Welt vor, in der alles, was wir uns anschauen und anhören, nahtlos in jeder Sprache läuft. Die Lieder, die unsere Eltern und Familien lieben, verstehen wir endlich; und unsere englischen Lieblingssongs gibt es auf Koreanisch und Chinesisch, damit unsere Eltern sie verstehen und selbst hören. Wer Englisch spricht, bekommt das Beste aus Korea, China und dem Rest der Welt. Alle anderen bekommen englische Inhalte ohne Untertitel.
Die übersetzten Songs will ich in meine Playlist packen.
 Andrew LiuCEOVon Mensch zu Mensch, nicht von KI zu KI →
Viele von uns im Team haben Englisch vor dem Fernseher gelernt. Unser CEO Andrew Liu konnte mit seinen Mitschülern kein Englisch sprechen, hatte keine Freunde und war der einzige asiatische Schüler an seiner ganzen Schule; die Sprache lernte er vor dem Fernseher, und das hat ihn nie wieder losgelassen.
Deshalb gibt es Familiar Labs: damit alles, was auf einem Bildschirm läuft, alle erreicht, in der Sprache, die sie verstehen.




▚ HALLOWEEN 2026 ▞
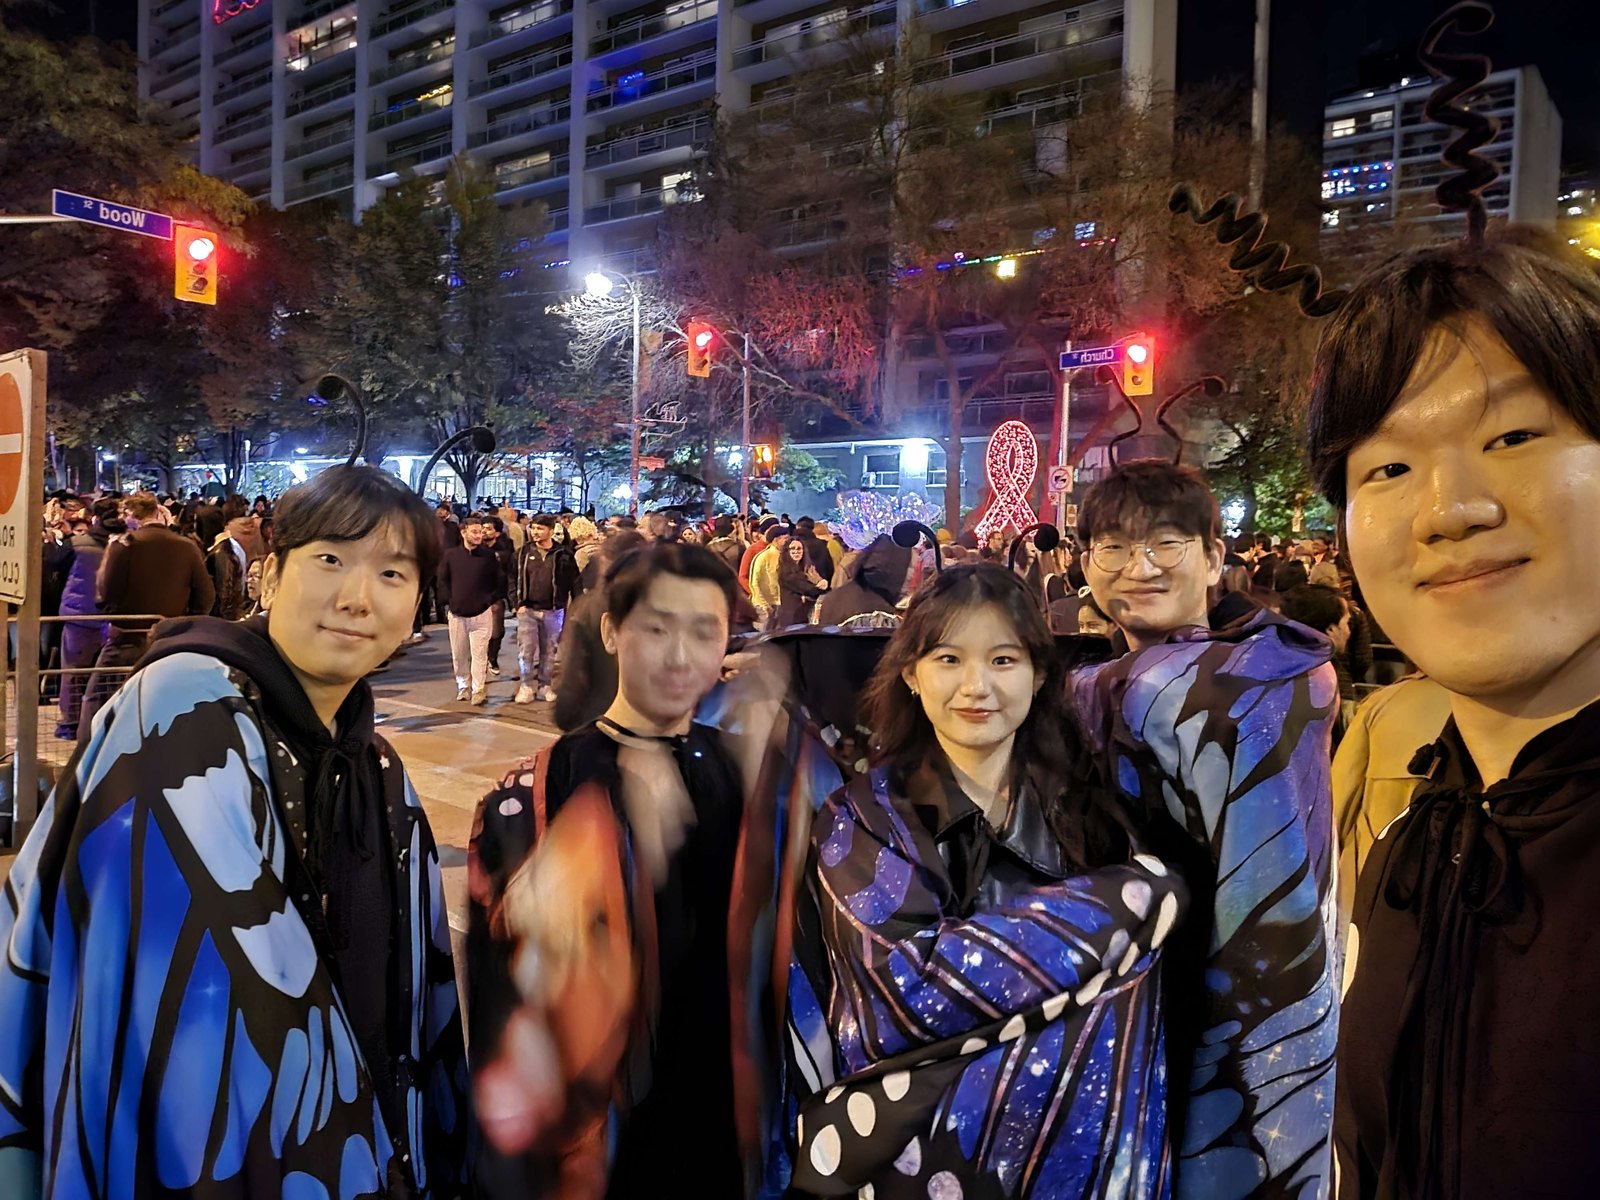
Halloween-Nacht in Toronto: Das Team hatte sich als Schmetterlinge verkleidet.
▚ FORSCHUNG ▞
Stimme und Gesicht kommen aus einem einzigen Modell, die Identität kann also nie auseinanderdriften: das Forschungsfeld, das wir mit JAM-Flow begründet haben.
Die derzeit realistischste Echtzeit-Animation von Menschen: SoulX-LiveAct animiert eine Person mit 20 Bildern pro Sekunde, eine Stunde lang stabil.
Destillation, Guidance und Sampling: die Forschung, die Diffusionsmodelle schnell genug für Echtzeit macht.
Editieren in eingefrorenen Diffusionsmodellen: von der Entdeckung des h-space über die Steuerung des Stils bis zum Entfernen von eingeblendetem Text.
Die Szene lesen, bevor sie editiert wird: wer gerade spricht, aus Bild und Ton gemeinsam, in jeder Umgebung.


▚ AUF DENSELBEN CLIPS GETESTET ▞


UNTERSTÜTZT VON


- Stanford
- Yonsei