La localisation multimodale au service des créatifs.
Le doublage est enfin bon.
La même performance Familiar Labs pour chaque public.
Comprendre chaque mot. Avec Familiar Labs, la performance reste entière.
- Musique et effets sonores
- Foules et rires
- Plusieurs intervenants
- Raisonnement spatial
- Jusqu'en 4K
- Stéréo et surround 5.1


▚ SONG DUBBING ▞
Une révolution musicale.
ÉMOTION. RYTHME. PRÉSERVÉS.
La voix et les lèvres du chanteur, portées dans une autre langue. Sors ton album dans le monde entier.
De l'espagnol vers l'anglais | extrait de deux minutes
Will Smith, Beautiful Scars | doublé en espagnol
THE RED PILL
VERSE 1 | WILL SMITH
CHORUS | OBANGA & BIG SEAN
VERSE 2 | BIG SEAN
CHORUS | OBANGA & BIG SEAN
VERSE 3 | WILL SMITH
CHORUS | OBANGA
- 01 / 03 | À 0:13
Les dents et les lèvres, trois fois
Deux personnes parlent dans cette image : les lèvres et les dents suivent l'espagnol sur le visage et sur les deux reflets de Will dans les lunettes.
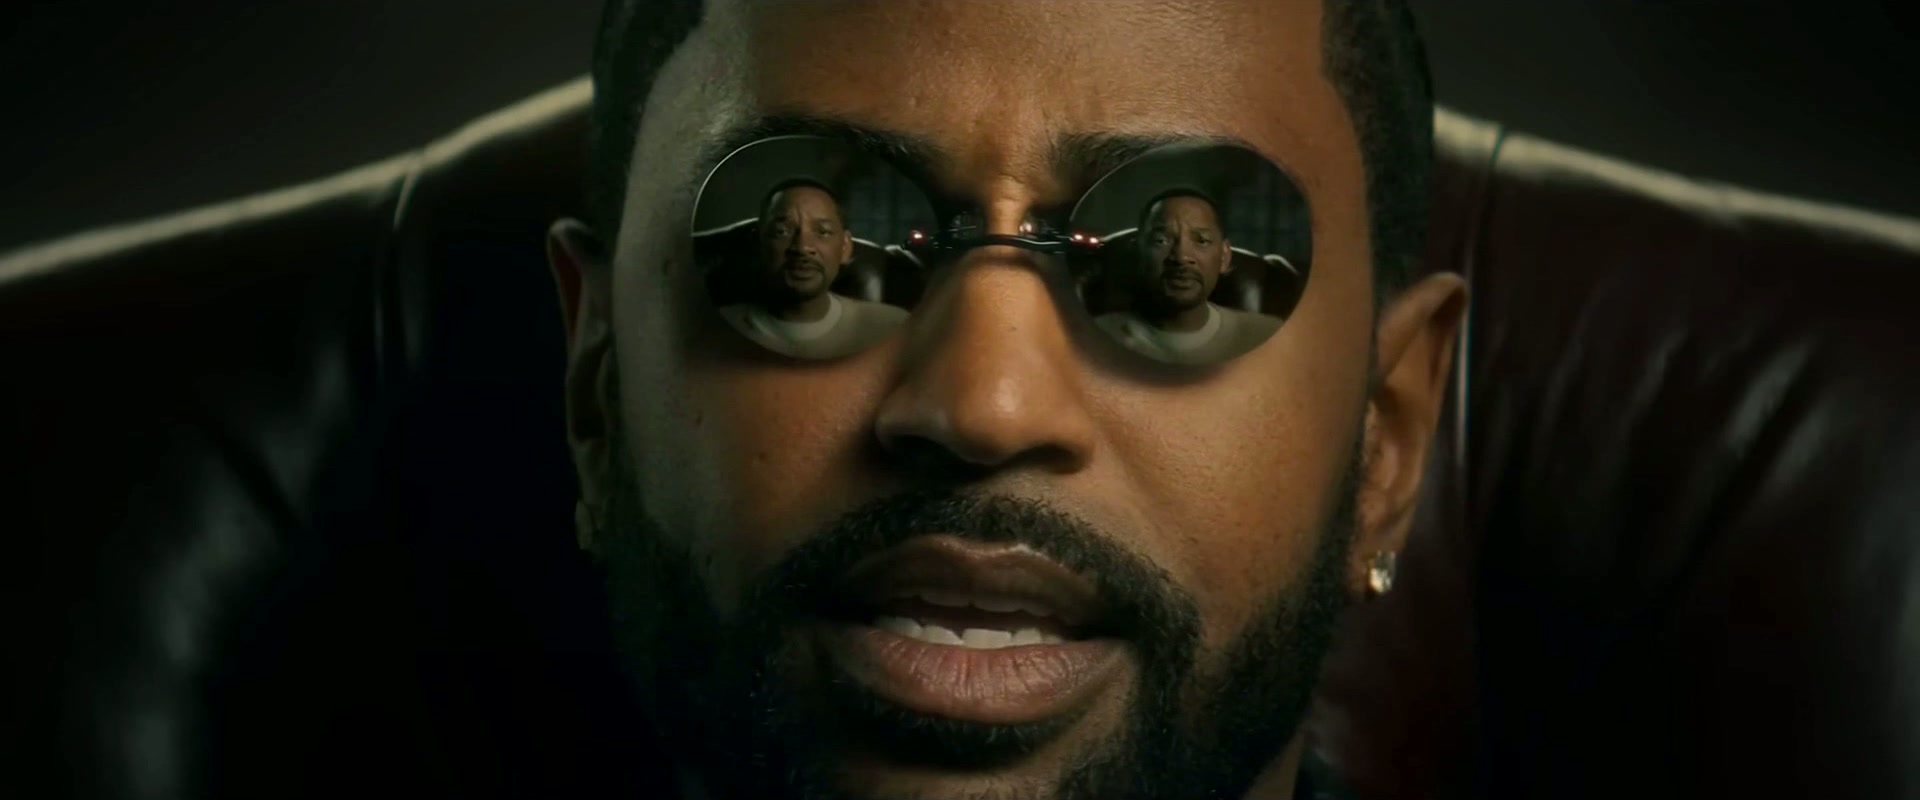 Doublé | voix et lèvres traduites en espagnol
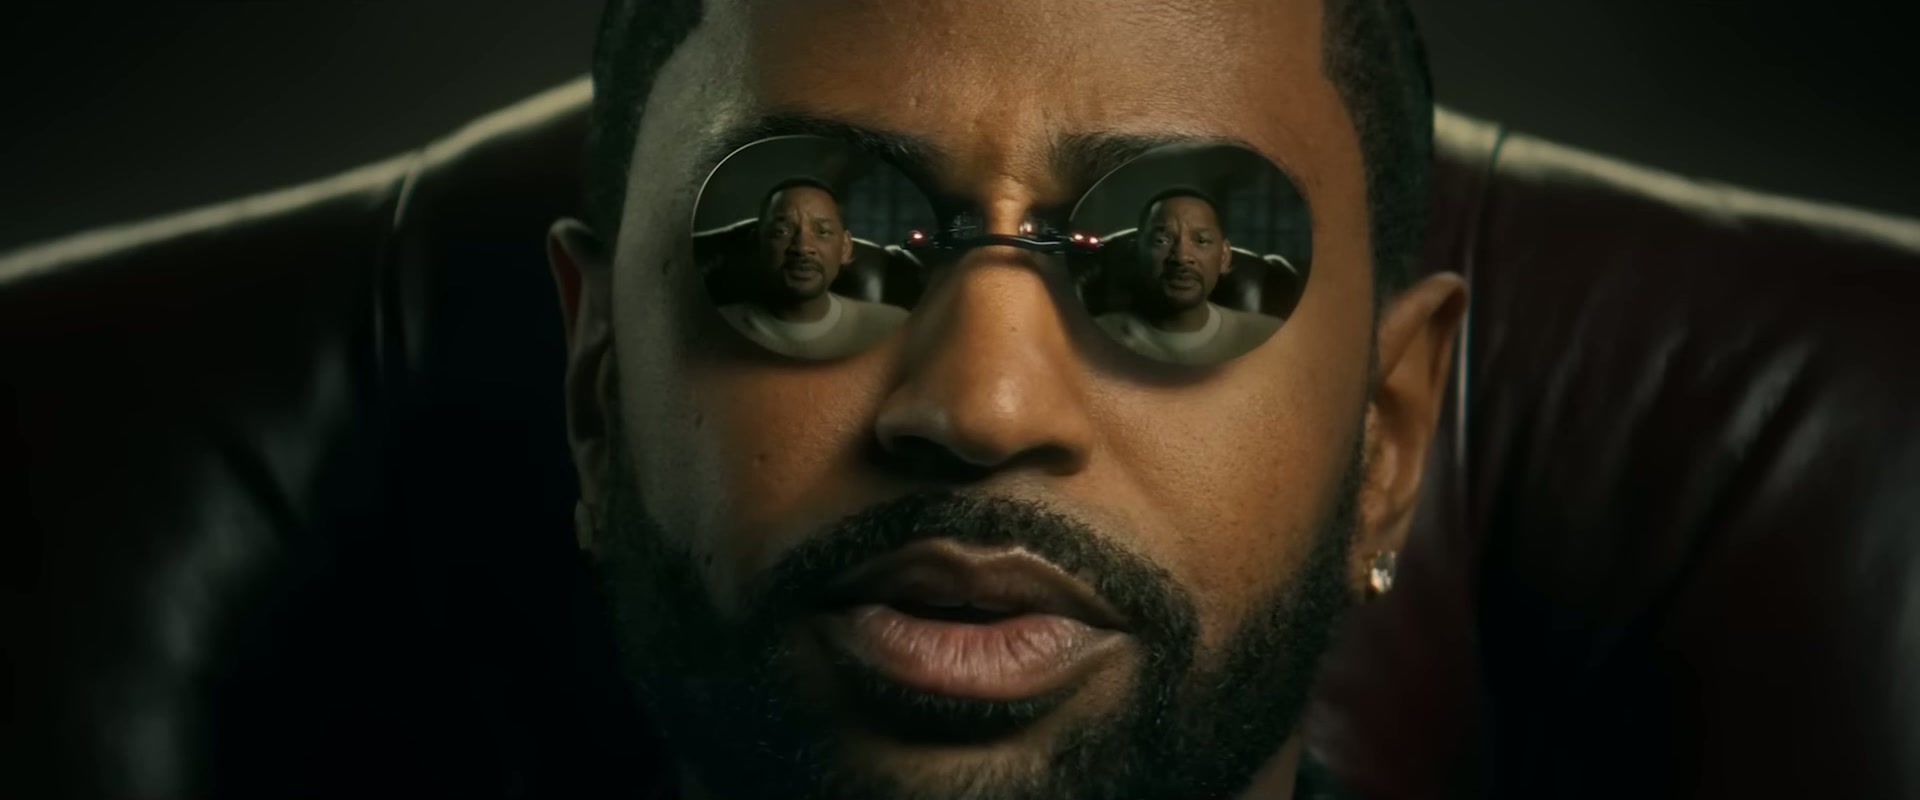 Original | en anglais, la même image
- 02 / 03 | À 2:30
Raisonnement spatial à travers un fisheye
L'objectif déforme tout le visage et une main cache celui de derrière ; le doublage tient.
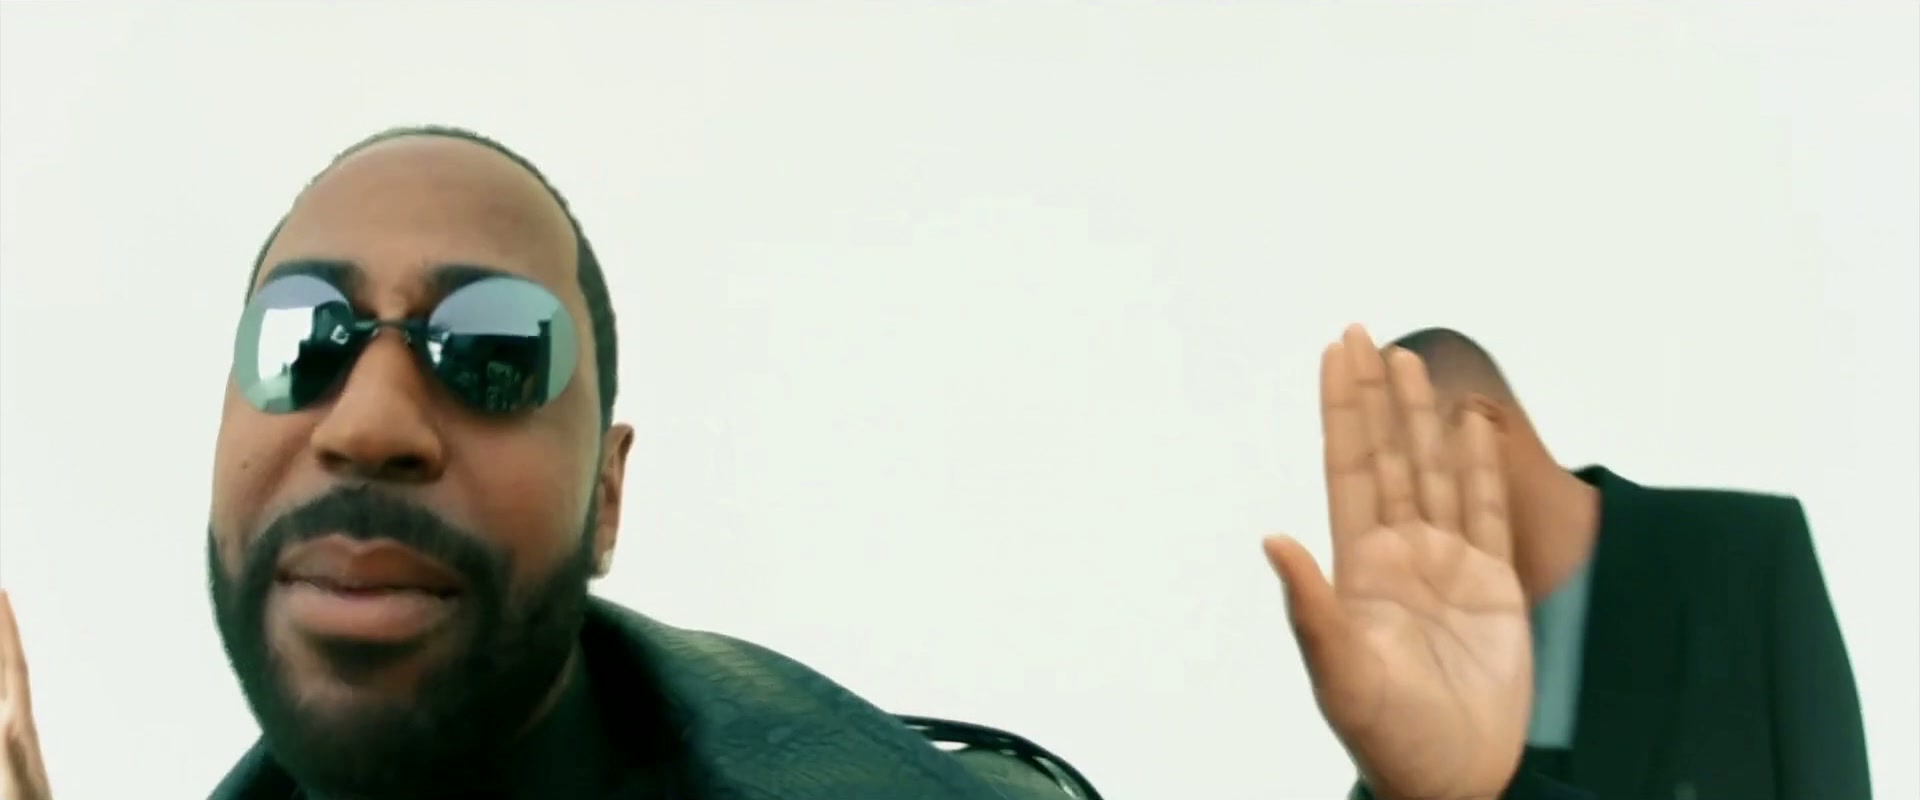 Doublé | voix et lèvres traduites en espagnol
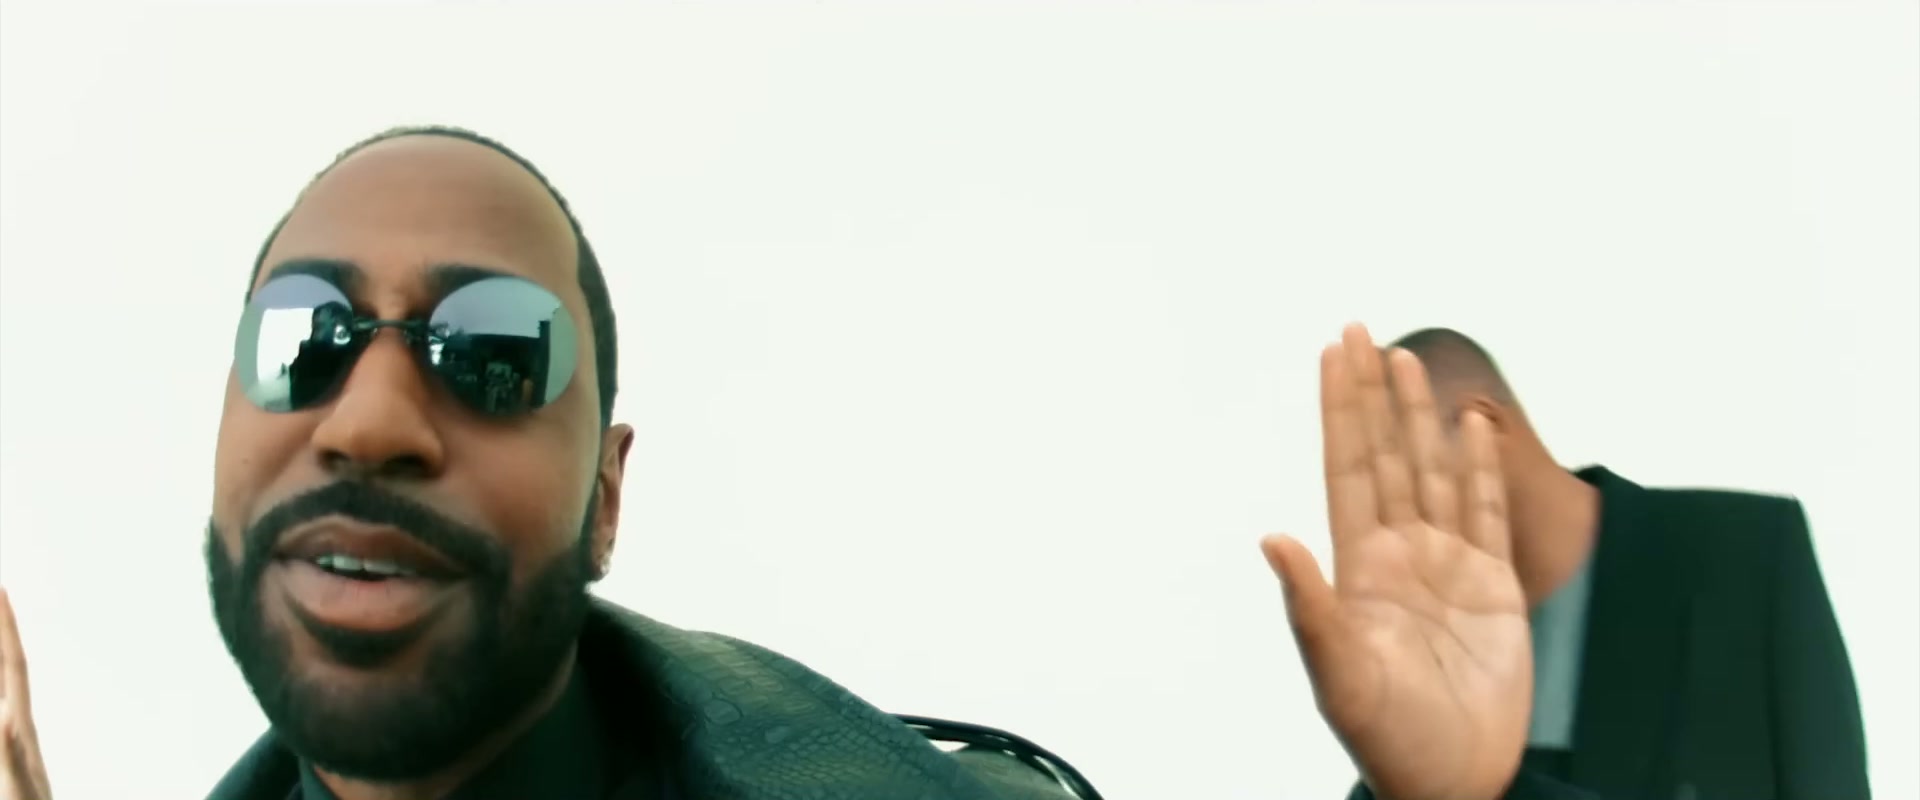 Original | en anglais, la même image
- 03 / 03 | À 3:40
Jusqu'au flou de mouvement
Un panoramique filé en plein vers : la bouche garde le même flou que le reste du plan.
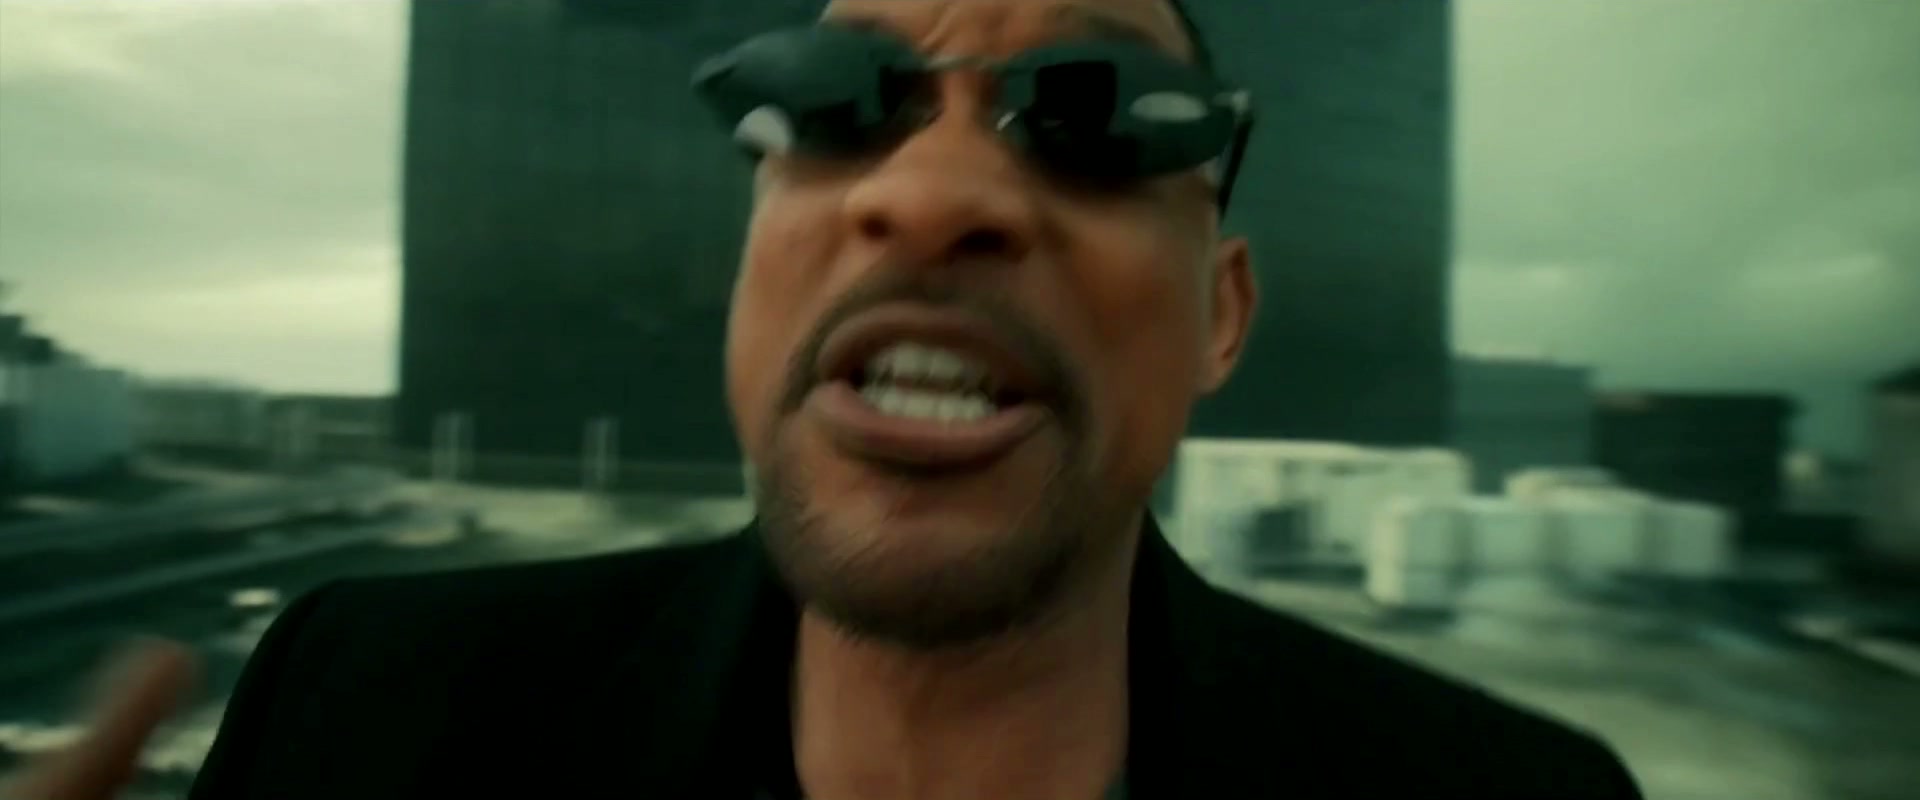 Doublé | voix et lèvres traduites en espagnol
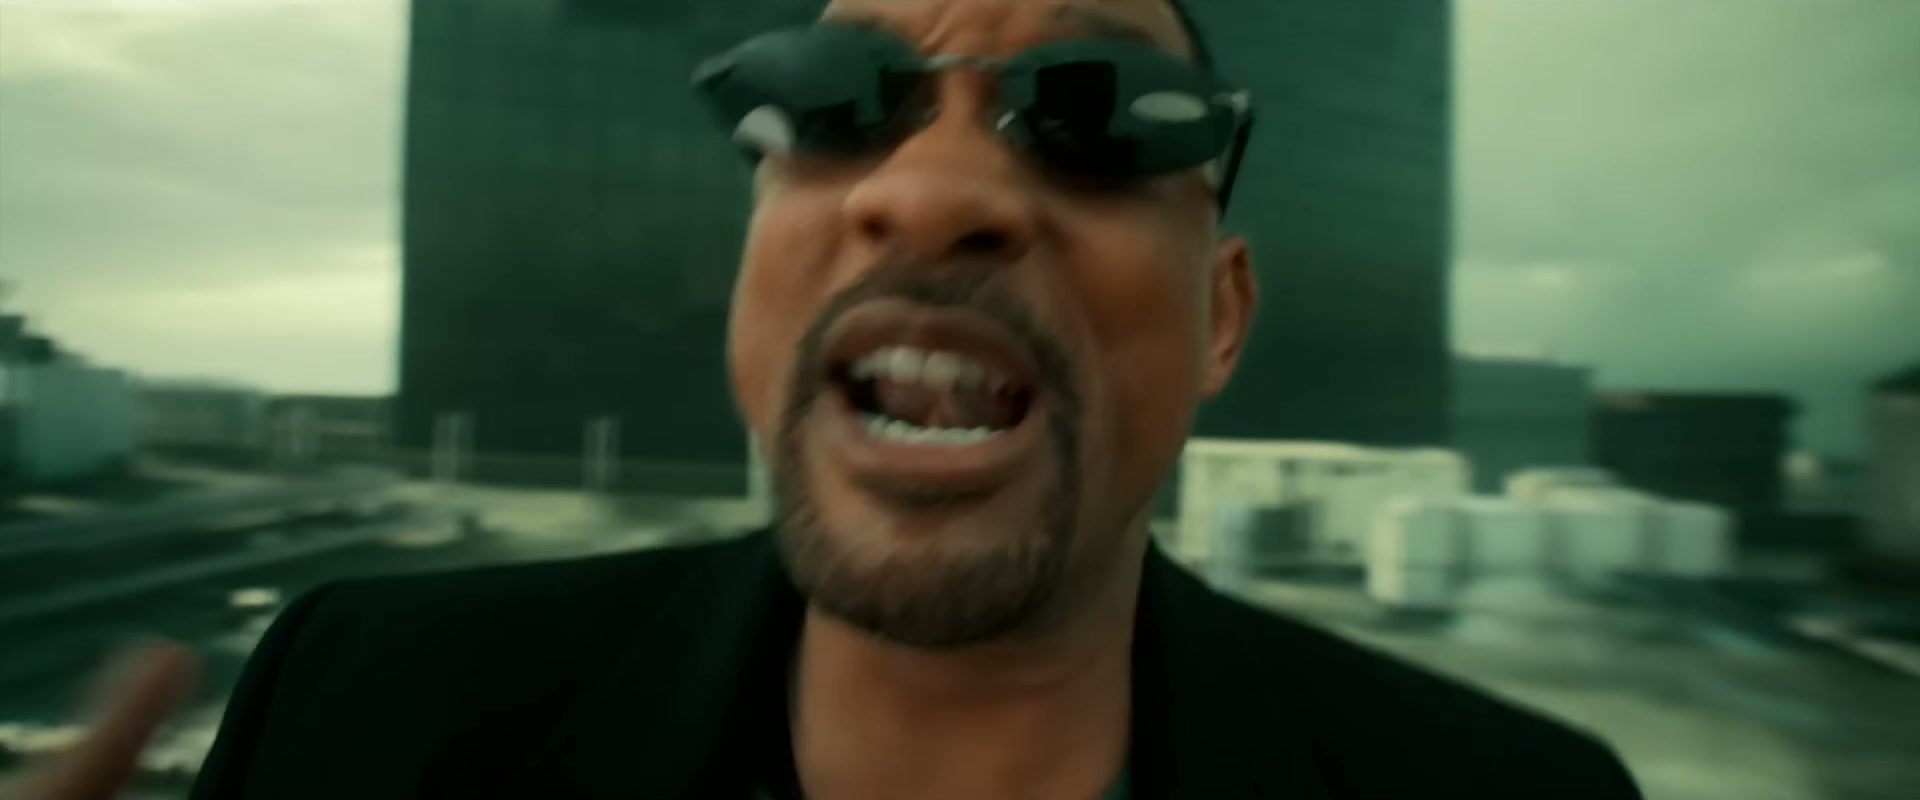 Original | en anglais, la même image
La performance reste si intacte que même les chansons passent dans une autre langue.
 Jibin SongDirectrice scientifiqueÉQUIPE →
Les chansons sont donc localisées elles aussi, où qu'elles soient :
- Films d'animation
- Contenus jeunesse
- Comédies musicales
- Chansons de films et de séries
- Génériques et intros
- Albums et clips
PLUS DE REVENUS, PLUS D'AUDIENCE.
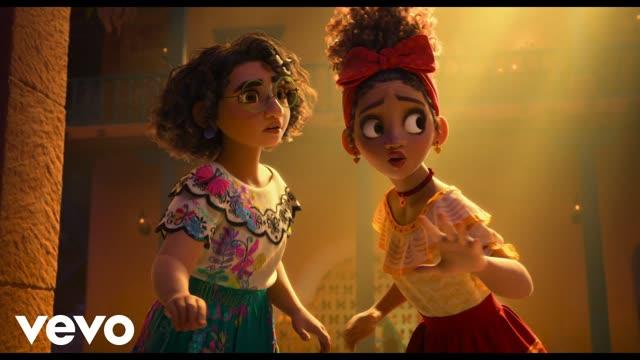 65%Ne parlons pas de Bruno | espagnol d'Amérique latineÀ elle seule, une version doublée a réuni 426 M de vues, soit 65% des 656 M de l'original anglais.
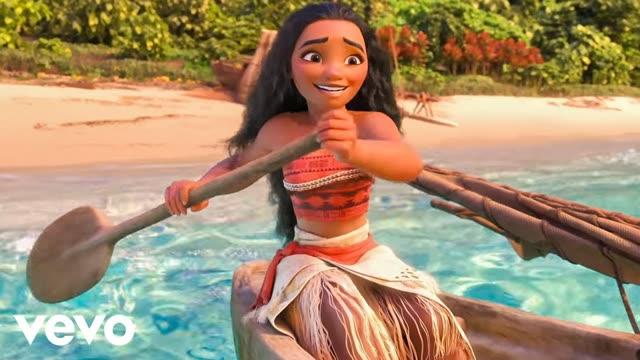 1,13 MdLe Bleu Lumière | portugais du BrésilLes vues de la version brésilienne sur YouTube, face à 1,54 milliard pour l'original anglais.
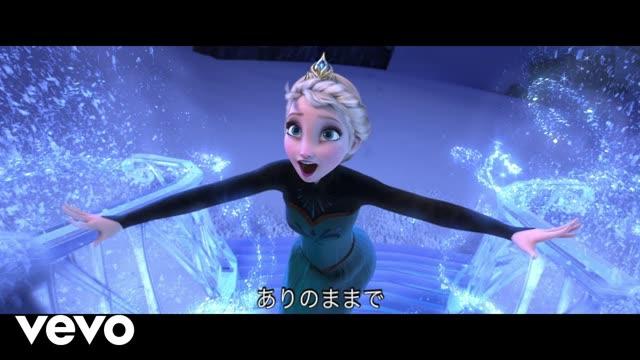 41Libérée, délivrée | languesL'album le plus vendu de 2014. Au Japon, la version locale a atteint la 2e place et la certification Million.
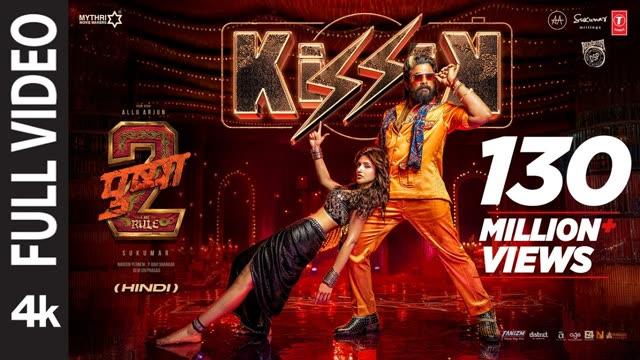 66%Pushpa 2 | hindiLa part du doublage en hindi dans le box-office du film en Inde ; l'original en télougou en a fait 27%.
Chacune a été rechantée par un interprète local. Avec Song Dubbing, c'est la performance originale qui voyage.
Maisons de disques : parler à l'équipe →23×
plus de minutes visionnées en streaming quand un titre bénéficie d'un doublage visuel.
FACE AU DOUBLAGE AUDIO SEUL DU MÊME TITRE
LA LIMITE DU DOUBLAGE HUMAIN
- Perte de l'interprétation
- Difficile à passer à l'échelle
- Coûteux
- L'IA actuelle ne suffit pas
▚ UNE SEULE PASSE, PAS DES SEMAINES ▞
D'abord la traduction, puis le doublage en une seule passe :
 Familiar Labs
 Flawless
 HeyGen
 ElevenLabsFamiliar LabsFlawlessHeyGenElevenLabs
Les outils d'assistance qu'utilise aujourd'hui le secteur exigent une équipe d'artistes VFX et des semaines par projet, et chaque langue est un nouveau projet.
Les outils en une seule passe d'aujourd'hui sacrifient tout le reste : la traduction n'est pas modifiable, la musique et l'ambiance disparaissent, la voix dérive, et les lèvres décrochent dès qu'il y a une main devant le visage, un micro, du flou, du bokeh, un plan de profil ou plusieurs personnes à l'image. Aucun raisonnement spatial, aucune compréhension du monde, aucun contrôle.
Familiar Labs face à Flawless TrueSync →SOUTENU PAR


 Stanford
 Yonsei

Pas de l'« IA générative », mais de la traduction au service des créatifs.
D'humain à humain, pas d'IA à IA →« L'IA générative est la branche de l'intelligence artificielle qui crée des contenus originaux, comme du texte, des images, de la vidéo, de l'audio ou du code informatique, en réponse aux prompts des utilisateurs. »

Le MLFM pour les tâches fastidieuses.
Aucun prompt. Rien de nouveau n'est généré au hasard.
D'humain à humain, pour toucher un public plus large.
Toutes les données qui ont servi à entraîner notre modèle ont été produites par l'équipe Familiar Labs elle-même.

Modèle de fondation multimodal pour la localisation.
Un nouveau paradigme, le premier du genre.
Un seul modèle qui décide ce qu'il faut localiser et comment, dans le texte, le son et l'image, et qui te montre les choix qui comptent.

Quelle traduction pour chaque réplique.
- Plusieurs traductions pesées ; tes directeurs artistiques voient les options argumentées et choisissent.
- Ce qui ne se traduit pas : l'argot gardé tel quel, le nom et la marque conservés.
- La référence remplacée par une autre que le public connaît, ce que la culture évite, les grossièretés atténuées pour le jeune public.
D'abord, quoi traduire.
- La voix principale repérée et doublée avec la voix même de la personne qui parle.
- Les rires, la foule, un cri, une voix que personne ne distingue : laissés tels quels.
- Un chant scandé, une exclamation, une expression gardés dans la langue d'origine.
Ce qu'il faut localiser à l'écran.
- Qui parle vraiment : qui raconte, qui parle hors champ.
- Les lèvres, occlusions et raisonnement spatial compris.
- Les expressions et les gestes, quand l'insistance ou la culture l'exige.
- Le texte à l'image, un écran de téléphone, une couverture de livre, un panneau de rue, une devanture, dans les termes que tu as déjà choisis.
- Ce qui reste tel que tourné, décidé à la volée : un paquet de Tostitos reste Tostitos.
- À quel visage appartient une réplique, et quel texte traduire.
Chaque décision est enregistrée avec le doublage. Tu peux revenir sur chacune d'elles, et un choix fait une fois vaut aussi pour l'épisode suivant.
Qu'est-ce que le MLFM ?▚ TESTÉ SUR LES MÊMES CLIPS ▞
Benchmarks
Occlusions et raisonnement spatial : micros devant la bouche, mains devant le visage, le doublage tient.

▚ L'API ▞
Ta plateforme, dans toutes les langues.
review=manualLes directeurs artistiques valident avant publication.
- Les répliques qui peuvent se lire de plusieurs façons, une blague ou une pique, reviennent en trois traductions d'intention et d'émotion différentes.
- Tes directeurs artistiques en choisissent une.
- Ils modifient n'importe quelle ligne face à l'original et lancent le doublage.
- 1Apples. I'm sorry, right down to the core.Jeu de mots gardé · penaud
- 2I came to say sorry. I brought apples.Le sens · sincère
- 3An apple a day keeps the silent treatment away.Autre blague · espiègle
- 1Wow. You're incredible.Sincère · chaleureux
- 2Well, aren't you something.Sarcastique · à froid
- 3Look at you, hotshot.Taquin · espiègle
/v1/dubs/dub_31xk9m/render- TRADUCTION00:12.4seg_12 · 사과하려고 사과 사 왔어.Apples. I'm sorry, right down to the core.I came to say sorry. I brought apples.An apple a day keeps the silent treatment away.Choix du directeur artistiqueEDITED
- SON00:41.2 – 00:44.0Crowd chantKeep in KoreanTranslateRevenir sur ce choix
- IMAGE00:58.0Phone screen · 내일 봐See you tomorrowKeep as shotRevenir sur ce choix
- IMAGE01:12.6SpeakerSpeaker 1Speaker 2Speaker 3Revenir sur ce choix
/v1/dubs/dub_31xk9m/decisions/GET /v1/dubs/{dub_id}/decisionsLe relevé des décisions : lis-le, reviens dessus.
Aujourd'hui, tes directeurs artistiques voient les options de traduction argumentées. Les décisions sur le son et l'image sont en préparation : un chant scandé gardé dans la langue d'origine, le visage auquel une réplique appartient, le texte d'un écran de téléphone.
Explorer la documentation →Inférence privée : nos propres GPU à Toronto, jamais un cloud public.
Chaque doublage est traité sur notre propre cluster à huit chiffres de GPU NVIDIA B300, les meilleurs du marché, à Toronto, au Canada. Tes médias ne sont jamais traités sur un cloud public comme Google Cloud ou AWS, ni par un prestataire d'inférence tiers : ils ne fuitent donc jamais.
Explorer la documentation →- GPUS
- NVIDIA B300, the best on the market
- CLUSTER
- Eight figures, USD
- LOCATION
- Toronto, Canada
- OPERATOR
- Familiar Labs, on compute we own
- PUBLIC CLOUD
- None
- THIRD-PARTY INFERENCE
- None
Réservé aux entreprises : un contrat Studio avec des tarifs dégressifs et un support dédié 24h/24 et 7j/7.
▚ LANGUES ▞
13 langues, de n'importe laquelle vers n'importe quelle autre.
Touche tous les publics, avec leur propre voix et leurs propres lèvres.
EN ENTRÉE ET EN SORTIE13
- allemand
- anglais
- arabe
- chinois
- coréen
- espagnol (Amérique latine)
- français (France)
- hindi
- italien
- japonais
- portugais (Brésil)
- russe
- thaï
▚ SÉCURITÉ ▞
Scellé sur ta machine. Ouvert uniquement à Toronto.
Tes contenus ne servent jamais à l'entraînement.
ENVOI SCELLÉ
Chiffré sur ta machine avant de quitter ton réseau : un fichier intercepté en transit reste illisible, et le doublage fini te revient scellé de la même façon.
NOS PROPRES SERVEURS À TORONTO
Traité et stocké sur une capacité de calcul qui nous appartient, à Toronto, au Canada ; aucun cloud public, aucun prestataire d'inférence tiers.
MOINDRE PRIVILÈGE
Les clés de déchiffrement sont détenues par deux responsables désignés ; personne en dehors de nos rôles de sécurité désignés ne peut ouvrir tes contenus.
SUPPRESSION PROGRAMMÉE
Supprimé dès que le doublage t'est remis (rétention zéro des données), à ta validation, ou automatiquement 14 jours après la livraison.
MEMBRE TPN+ | BONNES PRATIQUES DE SÉCURITÉ DES CONTENUS MPA
Pour les projets sous contrat des studios, des plateformes de streaming et des maisons de disques.

Des questions ?
Un doublage d'une génération d'avance : ta voix et tes lèvres, portées dans de nouvelles langues ; assembler ElevenLabs et HeyGen donne toujours un inconnu, à l'oreille comme à l'écran. Et c'est plus que de la synchronisation labiale par IA : tout le visage joue dans la nouvelle langue, occlusions et raisonnement spatial compris.
Dans notre benchmark publié :
- leur tout dernier produit a fait 270% d'erreurs en plus sur le fond sonore : les rires, la musique, l'ambiance
- 54.7% d'erreurs de traduction importantes en moins que leur tout dernier produit
- sur leur Dubbing v1, notre voix ressort 27.8% plus proche de la vraie voix du locuteur, et ce dans les 11 langues
Sur les mêmes clips, ElevenLabs :
- a omis ou inventé des mots 45 fois
- a cassé des rires et des bruitages 8 fois
- a perdu la voix du locuteur 6 fois
- a mélangé des voix qui se chevauchent 6 fois
- a aplati l'interprétation 4 fois
- a effacé l'ambiance de la scène 4 fois
- son API refuse les clips de moins de 11 secondes
Assembler ça toi-même revient à 11 $ la minute : 8 $ pour le lipsync de Sync.so, plus 3 $ pour l'audio d'ElevenLabs. Un doublage Familiar Labs comprend la voix, le lipsync et la traduction, jusqu'en 4K avec un vrai mixage surround 5.1 ou stéréo.