โลคัลไลเซชันแบบมัลติโมดัล เพื่อเสริมพลังคนทำงานสร้างสรรค์
ในที่สุดพากย์เสียงก็ดีซะที
การแสดงเดียวกันจาก Familiar Labs สำหรับผู้ชมทุกกลุ่ม
เข้าใจทุกคำ ได้การแสดงที่คุ้นเคยครบทุกรายละเอียด
- ดนตรีและเอฟเฟกต์เสียง
- ฝูงชนและเสียงหัวเราะ
- ผู้พูดหลายคน
- การให้เหตุผลเชิงพื้นที่
- สูงสุด 4K
- สเตอริโอและเสียงรอบทิศทาง 5.1


▚ SONG DUBBING ▞
ก้าวกระโดดของวงการเพลง
อารมณ์ จังหวะ ยังอยู่ครบ
เสียงและริมฝีปากของนักร้องคนเดิม ถ่ายทอดสู่อีกภาษาหนึ่ง ปล่อยอัลบั้มของคุณสู่ผู้ฟังทั่วโลก
ภาษาสเปนเป็นภาษาอังกฤษ | คลิปตัดช่วง 2 นาที
Will Smith, Beautiful Scars | พากย์เป็นภาษาสเปน
THE RED PILL
VERSE 1 | WILL SMITH
CHORUS | OBANGA & BIG SEAN
VERSE 2 | BIG SEAN
CHORUS | OBANGA & BIG SEAN
VERSE 3 | WILL SMITH
CHORUS | OBANGA
- 01 / 03 | ช่วง 0:13
ฟันและริมฝีปาก ครบทั้งสามจุด
ในเฟรมนี้มีคนพูดสองคน ริมฝีปากและฟันขยับตามภาษาสเปนทั้งบนใบหน้า และบนเงาสะท้อนของ Will ทั้งสองในแว่นตา
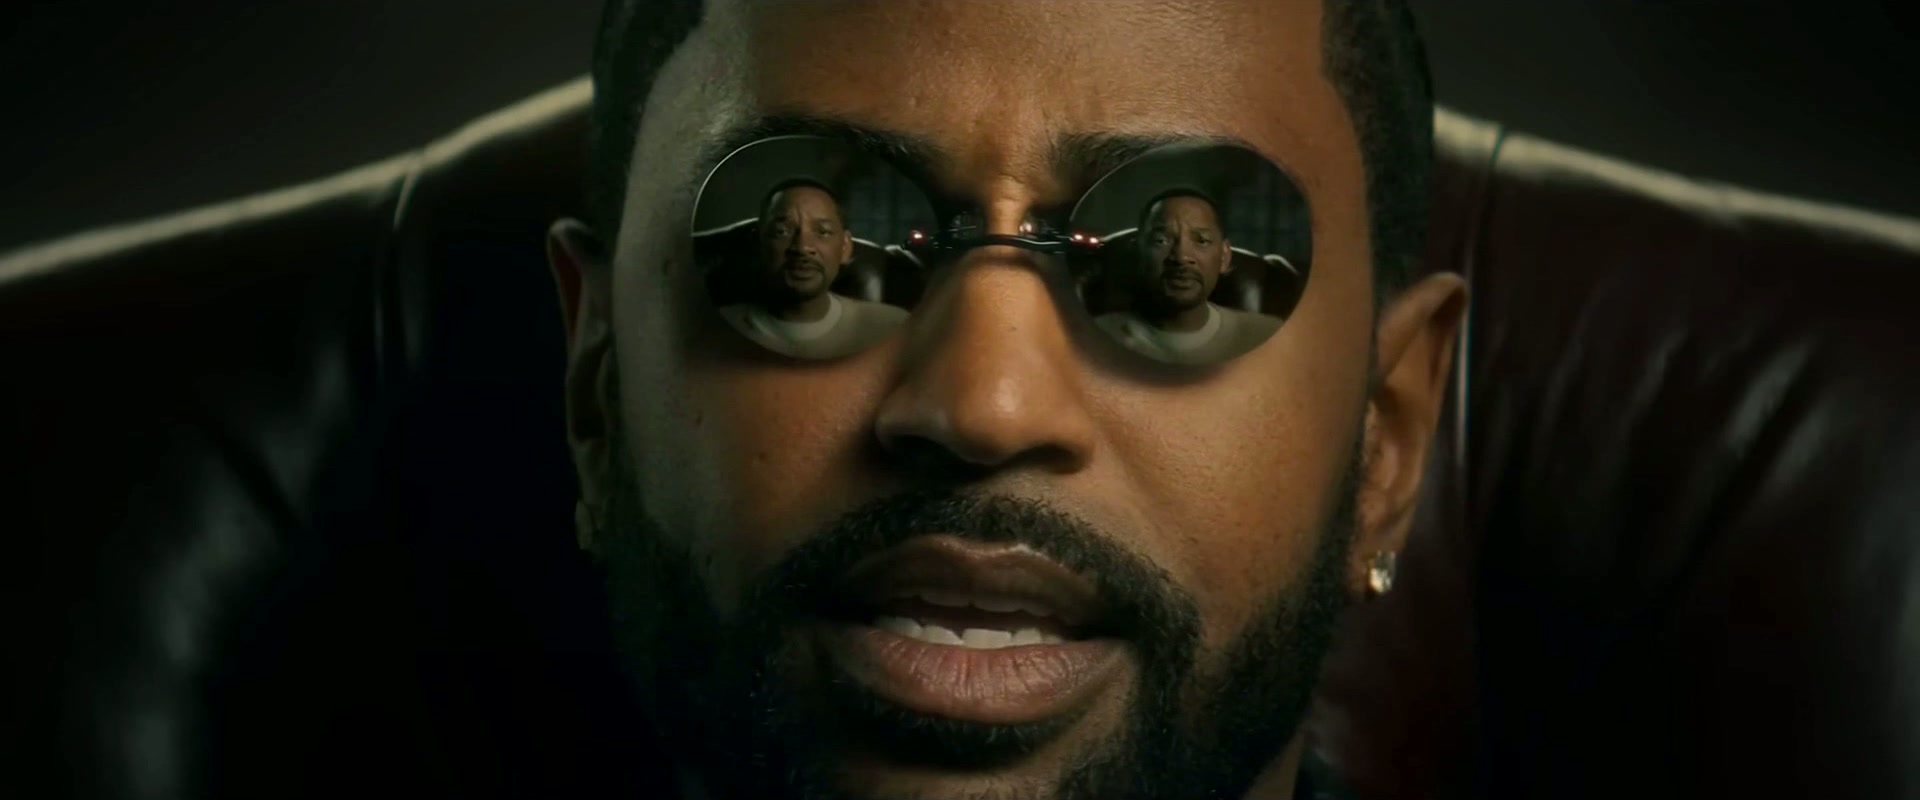 ฉบับพากย์ | แปลทั้งเสียงและริมฝีปากเป็นภาษาสเปน
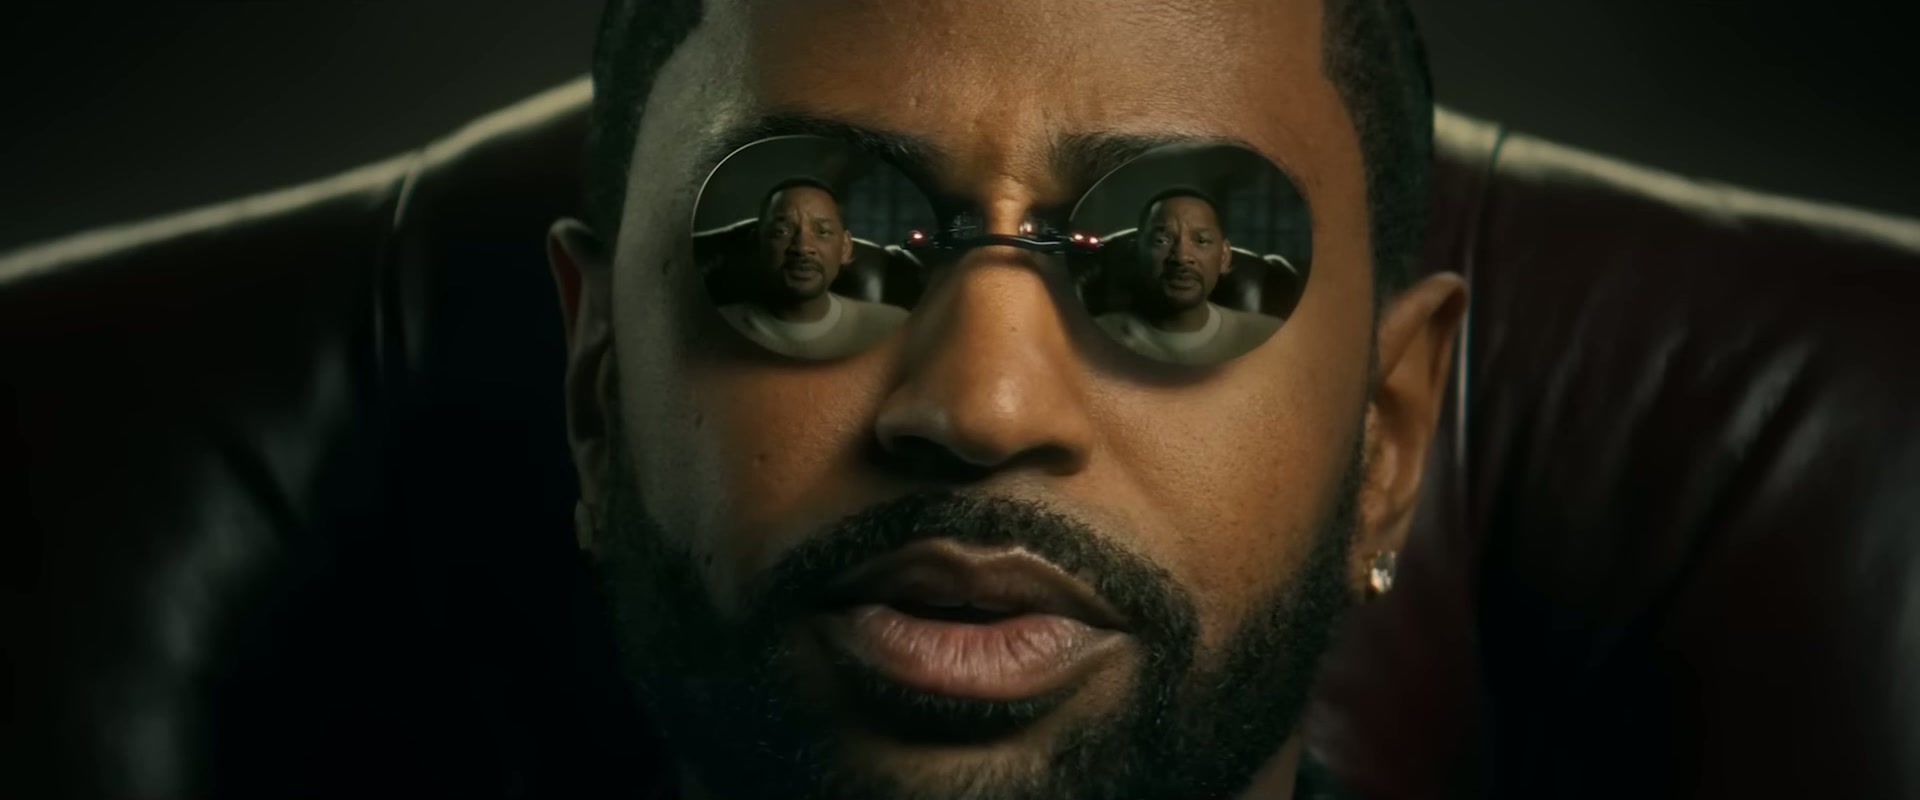 ต้นฉบับ | ภาษาอังกฤษ เฟรมเดียวกัน
- 02 / 03 | ช่วง 2:30
การให้เหตุผลเชิงพื้นที่ผ่านเลนส์ฟิชอาย
เลนส์บิดทั้งใบหน้า และมีมือบังใบหน้าที่อยู่ด้านหลัง งานพากย์ก็ยังเอาอยู่
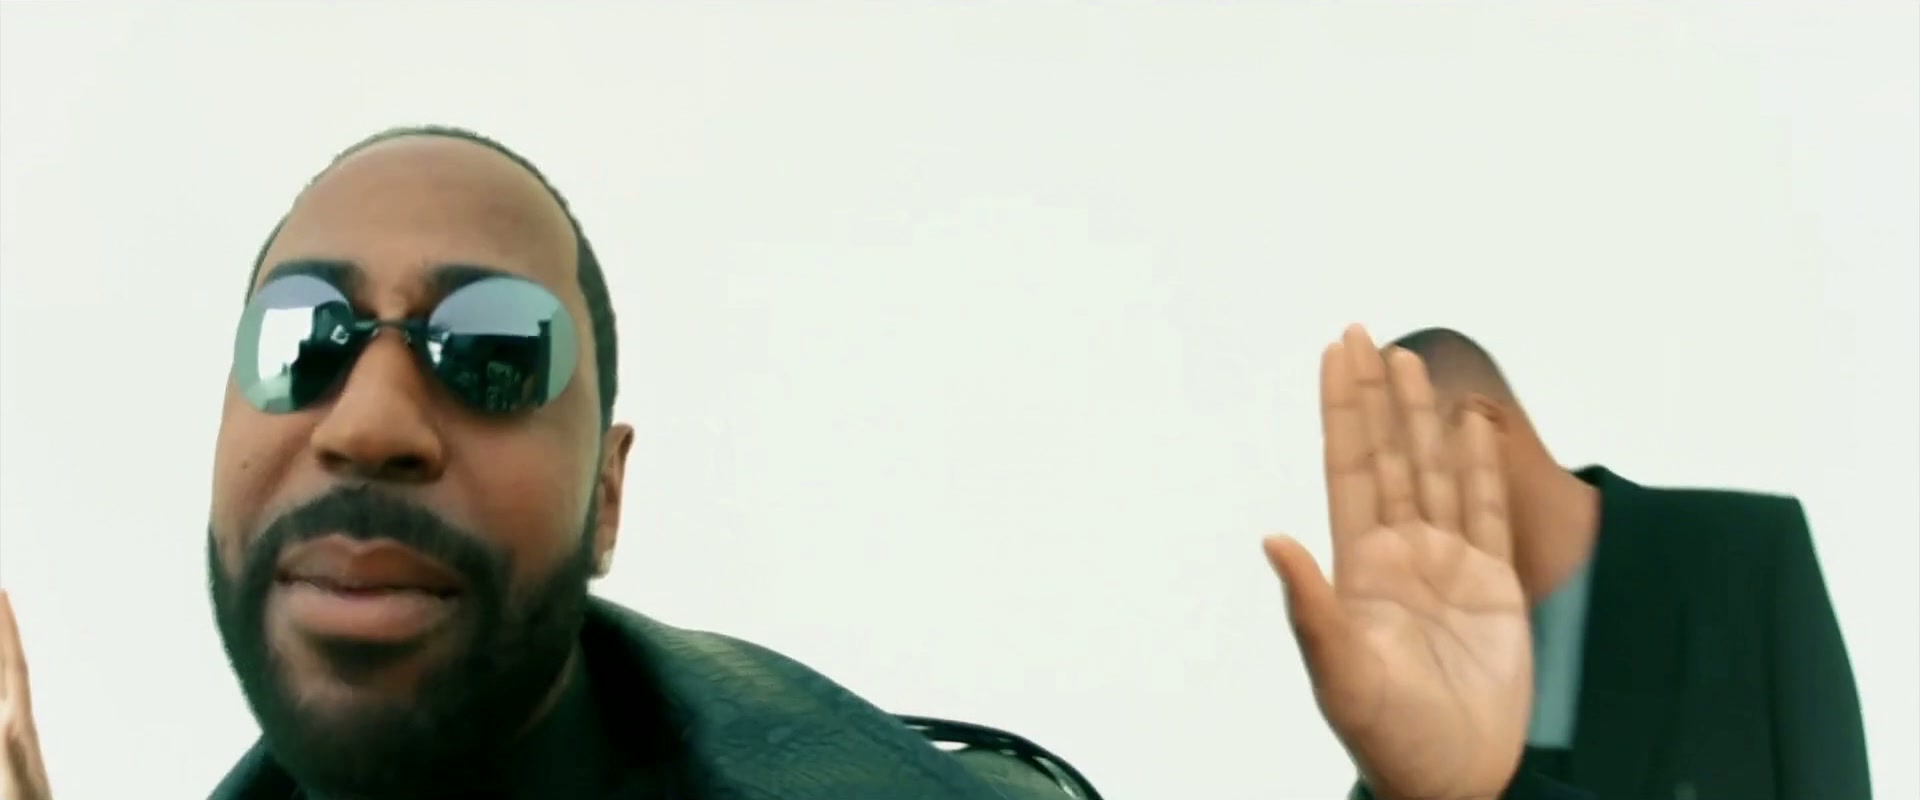 ฉบับพากย์ | แปลทั้งเสียงและริมฝีปากเป็นภาษาสเปน
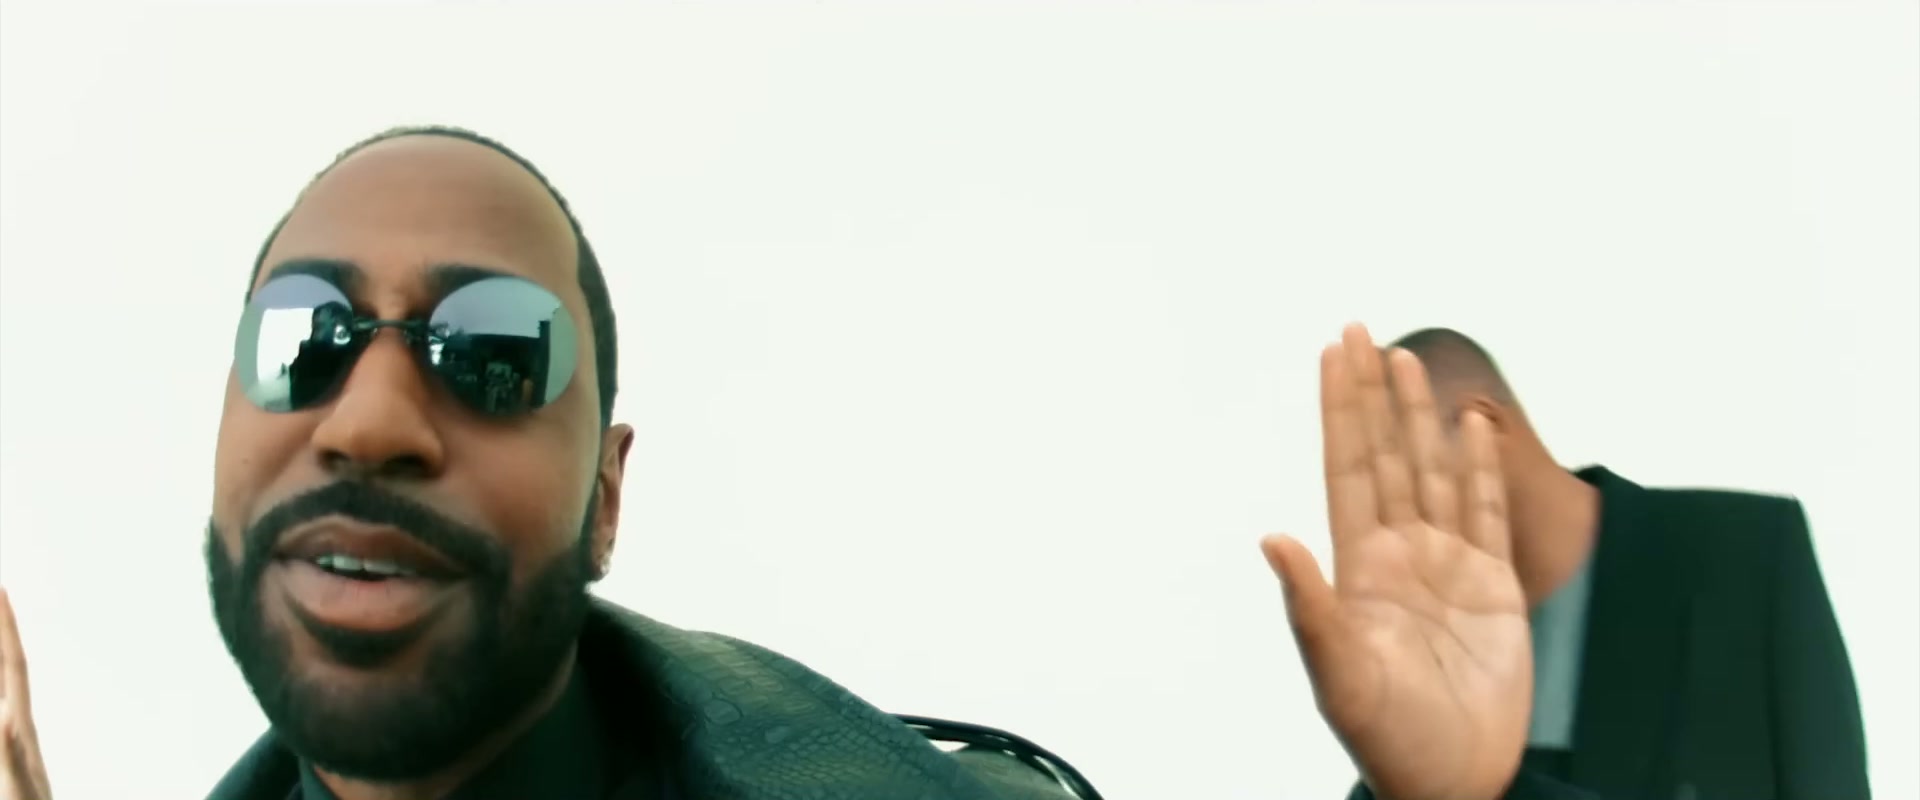 ต้นฉบับ | ภาษาอังกฤษ เฟรมเดียวกัน
- 03 / 03 | ช่วง 3:40
โมชันเบลอตรงกันทั้งช็อต
กล้องสะบัดเร็วกลางท่อนร้อง ปากก็เบลอเท่ากับส่วนอื่นของช็อต
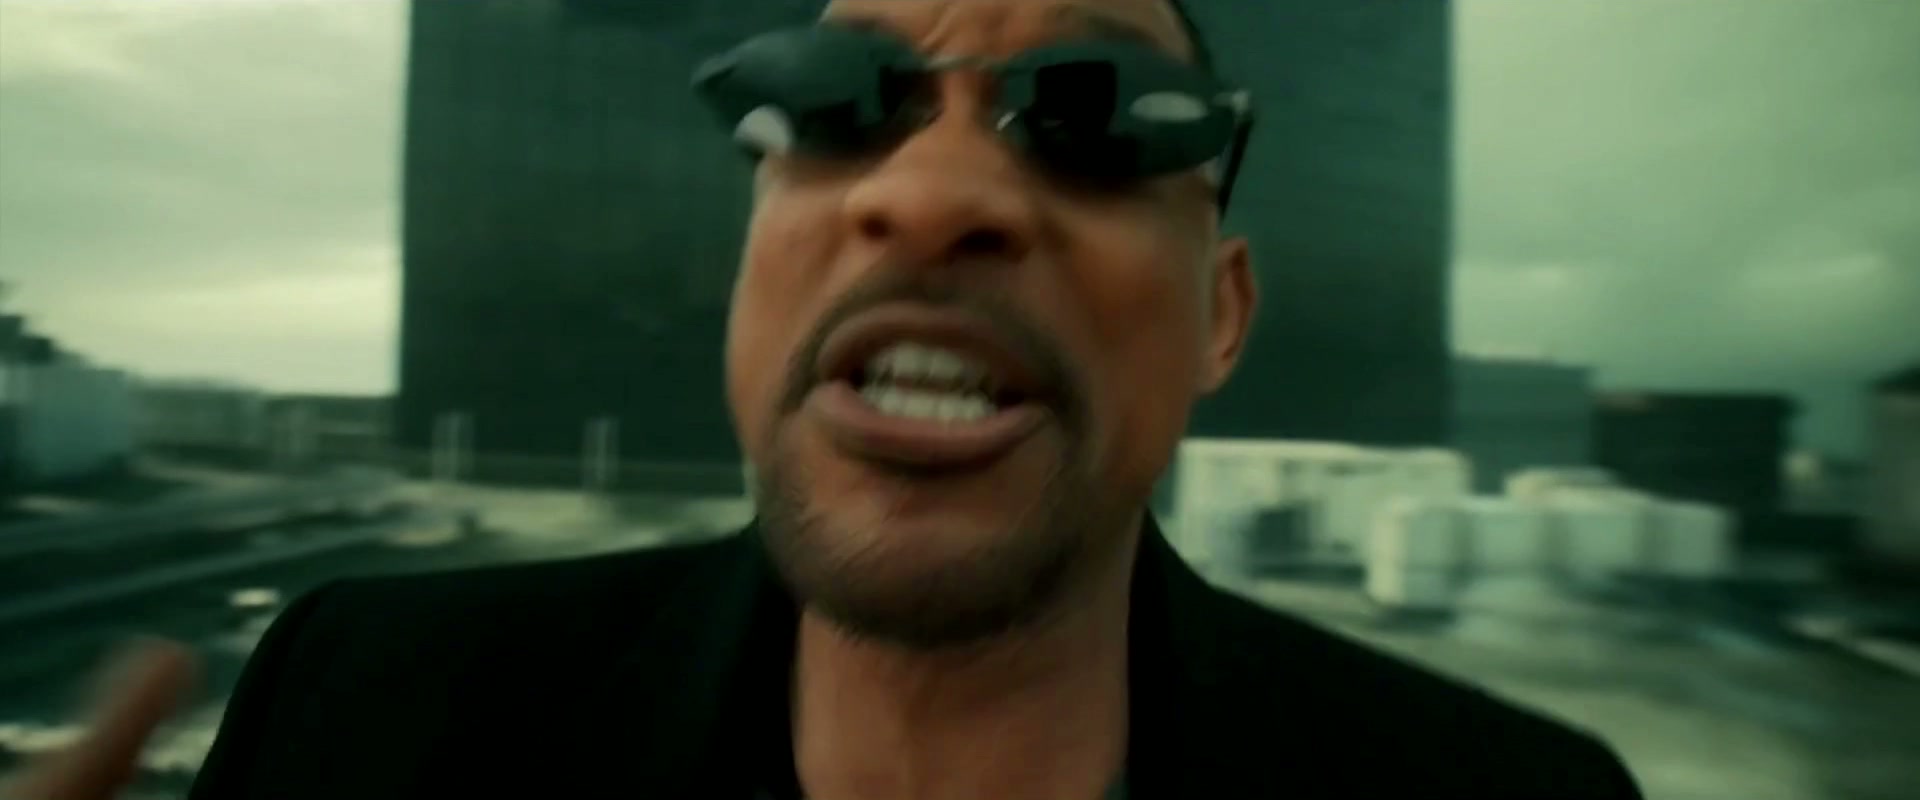 ฉบับพากย์ | แปลทั้งเสียงและริมฝีปากเป็นภาษาสเปน
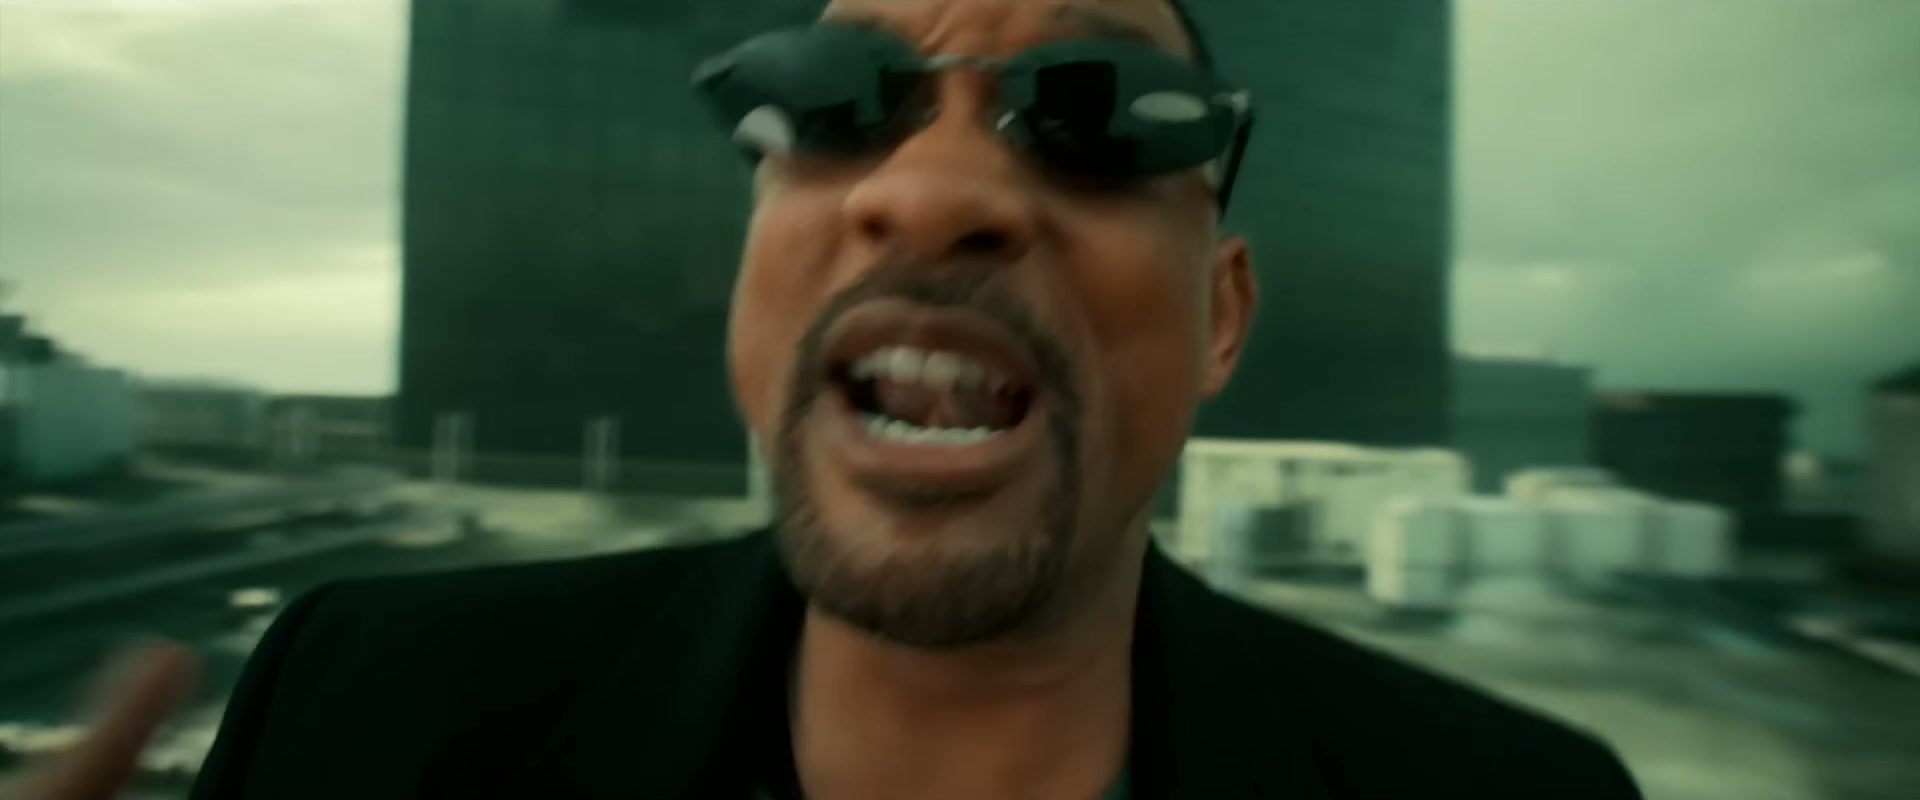 ต้นฉบับ | ภาษาอังกฤษ เฟรมเดียวกัน
การแสดงถูกถ่ายทอดมาได้ครบถ้วน จนแม้แต่เพลงก็ยังไปได้ดีในอีกภาษาหนึ่ง
 Jibin Songหัวหน้านักวิทยาศาสตร์ทีม →
เพลงจึงถูกพากย์ไปด้วย ไม่ว่าจะอยู่ในงานแบบไหน
- ภาพยนตร์แอนิเมชัน
- คอนเทนต์สำหรับเด็ก
- ละครเพลง
- เพลงในภาพยนตร์และซีรีส์
- เพลงธีมและเพลงเปิด
- อัลบั้มและมิวสิกวิดีโอ
เพิ่มรายได้ ขยายฐานผู้ฟัง
 65%We Don't Talk About Bruno | สเปน (ละตินอเมริกา)ฉบับพากย์เพียงภาษาเดียวทำยอดวิวได้ 426 ล้าน เท่ากับ 65% ของต้นฉบับภาษาอังกฤษที่มี 656 ล้านวิว
 1.13 พันล้านHow Far I'll Go | โปรตุเกส (บราซิล)ยอดวิวบน YouTube ของฉบับบราซิล เทียบกับ 1.54 พันล้านวิวของต้นฉบับภาษาอังกฤษ
 41Let It Go | ภาษาอัลบั้มขายดีที่สุดของปี 2014 ส่วนในญี่ปุ่น ฉบับภาษาญี่ปุ่นขึ้นถึงอันดับ 2 และได้รับการรับรองยอดขายระดับล้าน
 66%Pushpa 2 | ฮินดีสัดส่วนรายได้บ็อกซ์ออฟฟิศในอินเดียที่มาจากฉบับพากย์ภาษาฮินดี ส่วนต้นฉบับภาษาเตลูกูทำได้ 27%
ทุกเพลงข้างต้นต้องมีนักร้องท้องถิ่นร้องใหม่ แต่ด้วย Song Dubbing การแสดงต้นฉบับคือสิ่งที่เดินทางไปถึงผู้ฟัง
สำหรับค่ายเพลง ติดต่อเรา →23×
ยอดเวลารับชมที่มากขึ้น เมื่อเรื่องนั้นพากย์ทั้งเสียงและภาพ
เทียบกับเวอร์ชันพากย์เสียงอย่างเดียวของเรื่องเดียวกัน
ขีดจำกัดของการพากย์โดยมนุษย์
- การแสดงเดิมหายไป
- ขยายได้ยาก
- ค่าใช้จ่ายสูง
- AI ปัจจุบันยังไปไม่ถึง
▚ ครั้งเดียวจบ ไม่ใช่หลายสัปดาห์ ▞
แปลก่อน แล้วพากย์ทั้งหมดในครั้งเดียว
 Familiar Labs
 Flawless
 HeyGen
 ElevenLabsFamiliar LabsFlawlessHeyGenElevenLabs
เครื่องมือช่วยงานที่อุตสาหกรรมใช้กันอยู่ทุกวันนี้ต้องใช้ทีมศิลปิน VFX และเวลาหลายสัปดาห์ต่อโปรเจกต์ และทุกภาษาก็คือโปรเจกต์ใหม่
ส่วนเครื่องมือแบบครั้งเดียวจบในวันนี้ต้องยอมเสียอย่างอื่นไปทั้งหมด แก้คำแปลไม่ได้ เสียงดนตรีและเสียงบรรยากาศของห้องหายไป เสียงพากย์เพี้ยนไปจากผู้พูด และปากก็ขยับพลาดทันทีที่มีมือบังใบหน้า ไมโครโฟน ภาพเบลอ โบเก้ มุมข้าง หรือมีหลายคนอยู่ในเฟรม ไม่มีการให้เหตุผลเชิงพื้นที่ ไม่มีความเข้าใจโลก และไม่มีการควบคุม
Familiar Labs vs Flawless TrueSync →สนับสนุนโดย


 Stanford
 Yonsei

ไม่ใช่ “Generative AI” แต่คือการแปลที่เสริมพลังให้คนทำงานสร้างสรรค์
จากคนสู่คน ไม่ใช่จาก AI สู่ AI →“Generative AI คือสาขาหนึ่งของปัญญาประดิษฐ์ที่สร้างคอนเทนต์ใหม่ เช่น ข้อความ ภาพ วิดีโอ เสียง และโค้ดซอฟต์แวร์ ตามพรอมต์ของผู้ใช้”

MLFM สำหรับงานส่วนที่จุกจิกน่าเบื่อ
ไม่มีพรอมต์ ไม่ได้สุ่มสร้างอะไรขึ้นมาใหม่
จากคนสู่คน ไปถึงผู้ชมได้กว้างไกลกว่าเดิม
ข้อมูลทั้งหมดที่เราใช้เทรน ทีม Familiar Labs เป็นผู้สร้างขึ้นเองทั้งหมด

โมเดลพื้นฐานด้านโลคัลไลเซชันแบบมัลติโมดัล
กระบวนทัศน์ใหม่ ครั้งแรกของวงการ
โมเดลเดียวที่ตัดสินใจว่าจะปรับอะไรให้เข้ากับท้องถิ่น และปรับอย่างไร ทั้งในข้อความ เสียง และภาพ พร้อมแสดงตัวเลือกที่สำคัญให้คุณเห็น

จะแปลประโยคนี้แบบไหน
- ชั่งน้ำหนักคำแปลหลายแบบ ครีเอทีฟไดเรกเตอร์ของคุณเห็นตัวเลือกพร้อมเหตุผล แล้วตัดสินใจเอง
- อะไรไม่ต้องแปล คงคำสแลงไว้ตามที่พูด คงชื่อและแบรนด์เดิมไว้
- เปลี่ยนการอ้างอิงเป็นสิ่งที่ผู้ชมคุ้นเคย ระวังสิ่งที่วัฒนธรรมนั้นเลี่ยง ลดคำหยาบลงสำหรับเวอร์ชันผู้ชมอายุน้อย
เลือกว่าจะแปลอะไรบ้าง
- หาเสียงหลักที่ต้องแปล แล้วพากย์ด้วยเสียงของผู้พูดเอง
- เสียงหัวเราะ เสียงฝูงชน เสียงตะโกน เสียงคนพูดที่ฟังไม่ออก คงไว้อย่างเดิม
- เก็บเสียงร้องเชียร์ เสียงโห่ร้อง หรือวลีสั้นๆ ไว้เป็นภาษาต้นฉบับ
เลือกว่าจะปรับอะไรบนจอ
- ใครคือคนที่พูดจริงๆ ใครเป็นผู้บรรยาย ใครพูดจากนอกจอ
- ริมฝีปาก รวมถึงการบดบังและการให้เหตุผลเชิงพื้นที่
- สีหน้าและท่าทาง ในจังหวะที่ต้องเน้นหรือเมื่อวัฒนธรรมนั้นต้องการ
- ข้อความในเฟรม เช่น หน้าจอโทรศัพท์ ปกหนังสือ ป้ายถนน หน้าร้าน โดยใช้คำที่คุณเลือกไว้แล้ว
- ตัดสินใจทันทีว่าอะไรคงไว้ตามที่ถ่ายมา ถุง Tostitos ก็ยังเป็น Tostitos
- บทพูดไหนเป็นของใบหน้าไหน และจะแปลข้อความไหน
ทุกการตัดสินใจถูกบันทึกไว้กับงานพากย์นั้น คุณแก้ไขได้ทุกจุด และตัวเลือกที่ตัดสินใจไว้ครั้งหนึ่งจะตามไปใช้ในตอนถัดไปด้วย
MLFM คืออะไร▚ ทดสอบด้วยคลิปชุดเดียวกัน ▞
เบนช์มาร์ก
การบดบังและการให้เหตุผลเชิงพื้นที่: ไมค์บังปาก มือบังใบหน้า งานพากย์ก็ยังเอาอยู่

▚ API ▞
แพลตฟอร์มของคุณในทุกภาษา
review=manualครีเอทีฟไดเรกเตอร์ตรวจสอบก่อนปล่อยงาน
- บรรทัดที่ฟังได้หลายความหมาย ไม่ว่าจะเป็นมุกตลกหรือคำเหน็บแนม ระบบจะส่งคำแปลกลับมาให้สามแบบ ต่างกันทั้งเจตนาและอารมณ์
- ครีเอทีฟไดเรกเตอร์ของคุณเลือกมาหนึ่งแบบ
- แก้ไขบรรทัดใดก็ได้เทียบกับต้นฉบับ แล้วค่อยสั่งพากย์
- 1Apples. I'm sorry, right down to the core.คงมุกเล่นคำ · เขินๆ
- 2I came to say sorry. I brought apples.ตามความหมาย · จริงใจ
- 3An apple a day keeps the silent treatment away.มุกใหม่ · ขี้เล่น
- 1Wow. You're incredible.จริงใจ · อบอุ่น
- 2Well, aren't you something.ประชด · หน้าตาย
- 3Look at you, hotshot.แซว · ขี้เล่น
/v1/dubs/dub_31xk9m/render- การแปล00:12.4seg_12 · 사과하려고 사과 사 왔어.Apples. I'm sorry, right down to the core.I came to say sorry. I brought apples.An apple a day keeps the silent treatment away.ครีเอทีฟไดเรกเตอร์เลือกแบบนี้EDITED
- เสียง00:41.2 – 00:44.0Crowd chantKeep in KoreanTranslateแก้ไข
- ภาพ00:58.0Phone screen · 내일 봐See you tomorrowKeep as shotแก้ไข
- ภาพ01:12.6SpeakerSpeaker 1Speaker 2Speaker 3แก้ไข
/v1/dubs/dub_31xk9m/decisions/GET /v1/dubs/{dub_id}/decisionsบันทึกการตัดสินใจ: เปิดอ่านได้ แก้ไขได้
วันนี้ครีเอทีฟไดเรกเตอร์ของคุณเห็นคำแปลแต่ละแบบพร้อมเหตุผลได้แล้ว ส่วนการตัดสินใจด้านเสียงและภาพยังอยู่ระหว่างพัฒนา อย่างเสียงร้องเชียร์ที่คงไว้เป็นภาษาต้นฉบับ ประโยคนั้นเป็นของใบหน้าไหน หรือข้อความบนหน้าจอโทรศัพท์
สำรวจเอกสาร API →ประมวลผลบน GPU ของเราเองที่โทรอนโต ไม่ใช่คลาวด์สาธารณะ
งานพากย์ทุกชิ้นประมวลผลบนคลัสเตอร์ GPU NVIDIA B300 มูลค่าหลักสิบล้านดอลลาร์ของเราเอง ซึ่งเป็น GPU ที่ดีที่สุดในตลาดตอนนี้ ตั้งอยู่ที่โทรอนโต ประเทศแคนาดา สื่อของคุณจะไม่ถูกประมวลผลบนคลาวด์สาธารณะอย่าง Google Cloud หรือ AWS และไม่ผ่านผู้ให้บริการ inference ภายนอกรายใด จึงไม่รั่วไหลออกไป
สำรวจเอกสาร API →- GPUS
- NVIDIA B300, the best on the market
- CLUSTER
- Eight figures, USD
- LOCATION
- Toronto, Canada
- OPERATOR
- Familiar Labs, on compute we own
- PUBLIC CLOUD
- None
- THIRD-PARTY INFERENCE
- None
เฉพาะลูกค้าองค์กรเท่านั้น ภายใต้สัญญา Studio คิดราคาตามปริมาณ พร้อมทีมซัพพอร์ตดูแลโดยเฉพาะตลอด 24 ชม. ทุกวัน
▚ ภาษาที่รองรับ ▞
13 ภาษา แปลได้ทุกภาษาไปทุกภาษา
เข้าถึงผู้ชมได้ทุกกลุ่ม ด้วยเสียงและริมฝีปากของตัวเอง
ภาษาต้นทางและปลายทาง13
- เกาหลี
- จีน
- ญี่ปุ่น
- ไทย
- โปรตุเกส (บราซิล)
- ฝรั่งเศส (ฝรั่งเศส)
- เยอรมัน
- รัสเซีย
- สเปน (ละตินอเมริกา)
- อังกฤษ
- อาหรับ
- อิตาลี
- ฮินดี
▚ ความปลอดภัย ▞
ปิดผนึกบนเครื่องของคุณ เปิดได้ที่โทรอนโตเท่านั้น
คอนเทนต์ของคุณไม่ถูกนำไปใช้เทรนโมเดลเด็ดขาด
อัปโหลดแบบปิดผนึก
เข้ารหัสบนเครื่องของคุณก่อนไฟล์จะออกจากเครือข่ายของคุณ ไฟล์ที่ถูกดักกลางทางระหว่างการส่งจึงอ่านไม่ได้ และงานพากย์ที่เสร็จแล้วก็ส่งกลับไปแบบปิดผนึกด้วยวิธีเดียวกัน
เซิร์ฟเวอร์ของเราเองที่โทรอนโต
ประมวลผลและจัดเก็บบนทรัพยากรประมวลผลที่เราเป็นเจ้าของเองที่โทรอนโต ประเทศแคนาดา ไม่ใช้คลาวด์สาธารณะ ไม่ผ่านผู้ให้บริการ inference ภายนอก
สิทธิ์น้อยที่สุด
คีย์ถอดรหัสอยู่กับเจ้าหน้าที่สองคนที่ระบุชื่อ นอกจากผู้มีบทบาทด้านความปลอดภัยที่ระบุชื่อไว้ ไม่มีใครเปิดคอนเทนต์ของคุณได้
ลบตามกำหนด
ลบทันทีที่ส่งงานพากย์กลับไป (ไม่เก็บข้อมูลไว้เลย) เมื่อคุณอนุมัติงาน หรือโดยอัตโนมัติเมื่อครบ 14 วันหลังส่งมอบ
สมาชิก TPN+ | แนวปฏิบัติที่ดีด้านความปลอดภัยของคอนเทนต์ของ MPA
สำหรับงานของสตูดิโอ แพลตฟอร์มสตรีมมิ่ง และค่ายเพลงที่ทำภายใต้สัญญา

มีคำถาม?
งานพากย์ที่ก้าวกระโดดไปอีกขั้น: เสียงและริมฝีปากของคุณ ถ่ายทอดสู่ภาษาใหม่ เอา ElevenLabs กับ HeyGen มาต่อกัน ทั้งเสียงทั้งหน้าก็ยังเหมือนคนแปลกหน้าอยู่ดี และนี่ไม่ใช่แค่ลิปซิงค์ด้วย AI แต่ทั้งใบหน้าแสดงเป็นภาษาใหม่ รวมถึงการบดบังและการให้เหตุผลเชิงพื้นที่
- ผลิตภัณฑ์ใหม่ล่าสุดของเขาทำข้อผิดพลาดด้านเสียงพื้นหลังมากกว่าถึง 270% ทั้งเสียงหัวเราะ เสียงดนตรี และเสียงบรรยากาศ
- เราแปลผิดจุดสำคัญน้อยกว่าผลิตภัณฑ์นั้นถึง 54.7%
- บน Dubbing v1 ของเขา เสียงของเราเหมือนผู้พูดตัวจริงมากกว่าถึง 27.8% ใกล้เคียงกว่าครบทั้ง 11 ภาษา
กับคลิปชุดเดียวกัน ElevenLabs
- ทำคำตกหล่นหรือแต่งคำขึ้นมาเอง 45 ครั้ง
- เสียงหัวเราะและเสียงประกอบพังไป 8 ครั้ง
- เสียงหลุดจากตัวผู้พูด 6 ครั้ง
- เสียงคนที่พูดซ้อนกันตีกัน 6 ครั้ง
- ลีลาการพูดแบนเรียบไป 4 ครั้ง
- เสียงบรรยากาศของฉากหายไป 4 ครั้ง
- API ของเขาไม่รับคลิปที่สั้นกว่า 11 วินาที
ถ้าเอาเครื่องมือมาต่อกันเองจะตกอยู่ที่ $11 ต่อนาที คือค่าลิปซิงค์ของ Sync.so $8 บวกค่าเสียงของ ElevenLabs อีก $3 ส่วนงานพากย์ของ Familiar Labs มาครบทั้งเสียง ลิปซิงค์ และการแปล ส่งมอบที่ความละเอียดสูงสุด 4K พร้อมมิกซ์เสียงรอบทิศทาง 5.1 แท้ หรือสเตอริโอ