ทีม
ปริญญาเอกและนักวิจัย
 Stanford
 Yonsei

เราก่อตั้งขึ้นเพื่อทำลายทุกกำแพงที่ขวางกั้นความเข้าใจ
ลองนึกภาพโลกที่ทุกอย่างที่เราดูและฟัง เล่นได้อย่างไร้รอยต่อในทุกภาษา เพลงที่พ่อแม่และครอบครัวของเรารัก ในที่สุดเราก็เข้าใจได้ และเพลงภาษาอังกฤษที่เราชอบก็มีเป็นภาษาเกาหลีและภาษาจีน ให้พวกท่านเข้าใจและได้ฟังไปด้วยกัน คนที่พูดภาษาอังกฤษได้ดูของดีที่สุดจากเกาหลี จีน และทุกมุมโลก ส่วนคนอื่น ๆ ก็ได้ดูคอนเทนต์ภาษาอังกฤษโดยไม่ต้องพึ่งซับไตเติล
อยากเพิ่มเพลงแปลพวกนี้เข้าเพลย์ลิสต์ของผมเลย
 Andrew LiuCEOจากคนสู่คน ไม่ใช่จาก AI สู่ AI →
หลายคนในทีมของเราเรียนภาษาอังกฤษมาจากทีวี Andrew Liu CEO ของเรา เคยพูดภาษาอังกฤษกับเพื่อนร่วมชั้นไม่ได้ ไม่มีเพื่อนสักคน และเป็นคนเอเชียเพียงคนเดียวในโรงเรียนทั้งโรงเรียน เขาเรียนภาษาจากการดูทีวี และมันติดตัวเขามาจนทุกวันนี้
นี่คือเหตุผลที่ Familiar Labs เกิดขึ้น เพื่อให้ทุกอย่างที่ฉายบนจอไปถึงทุกคน ในภาษาที่เขาเข้าใจ




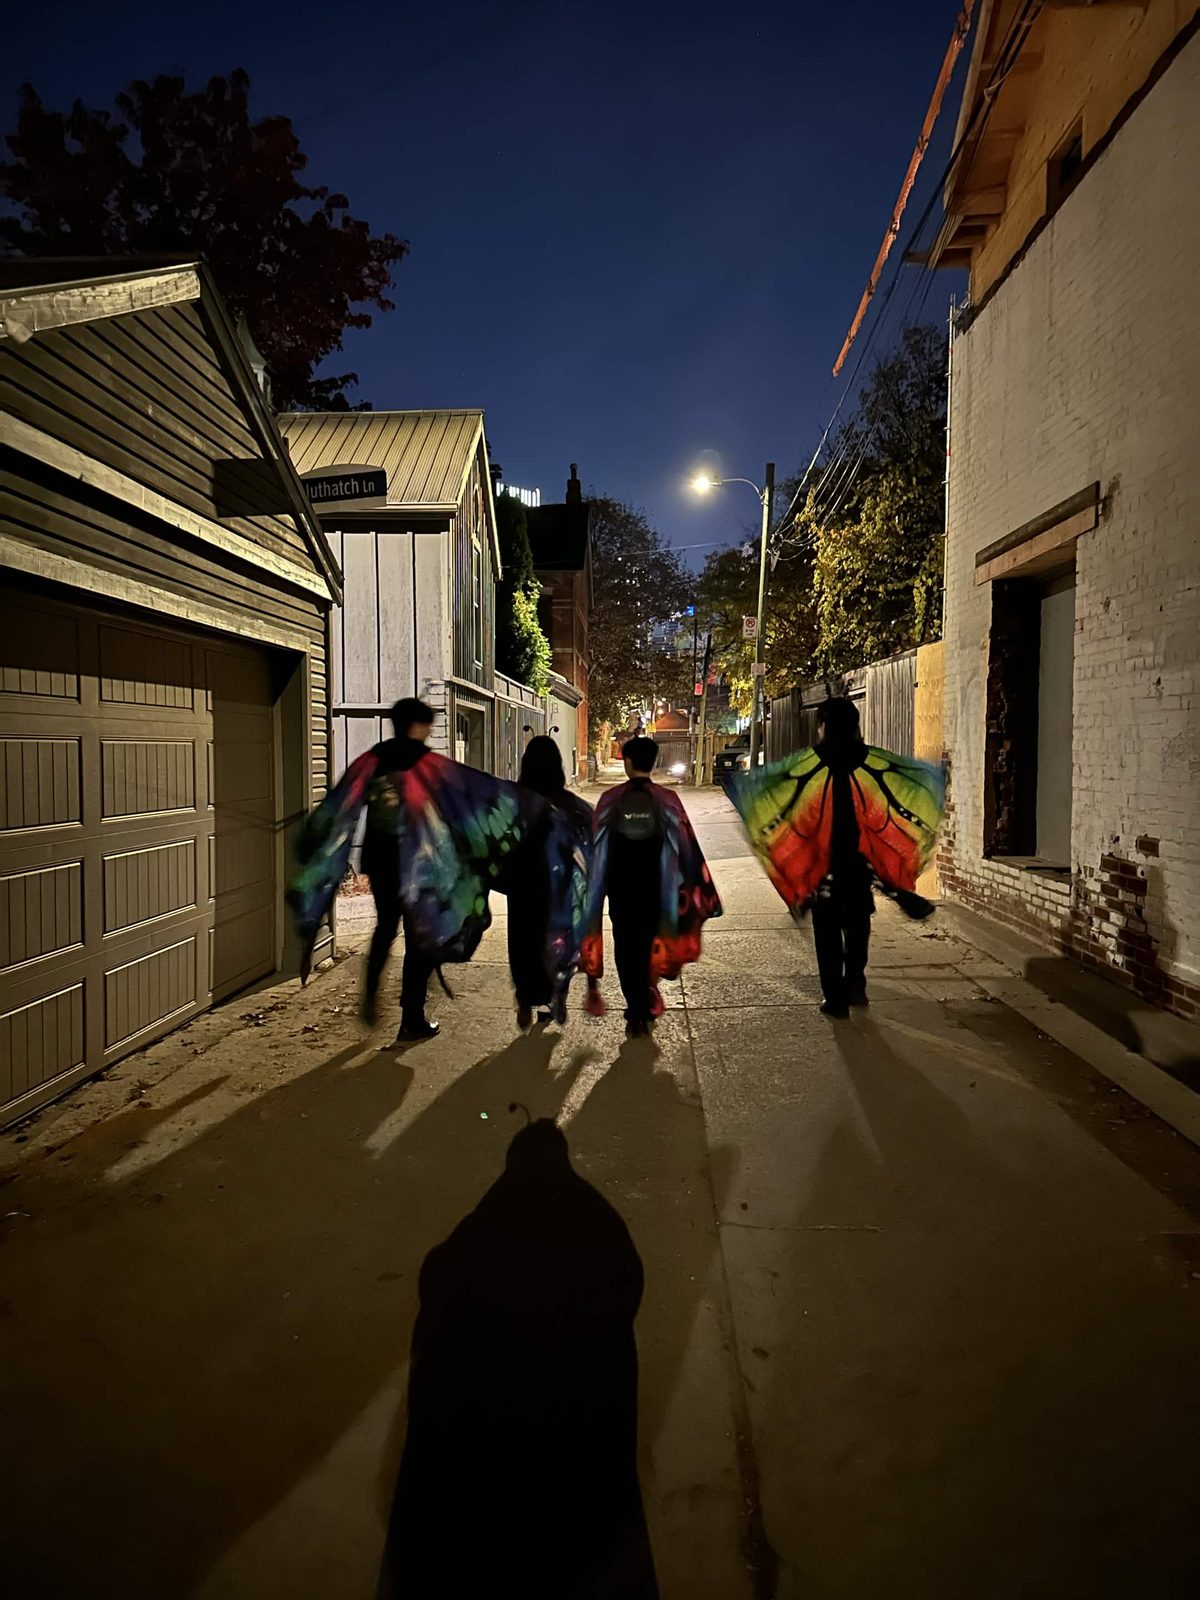
▚ ฮาโลวีน 2026 ▞
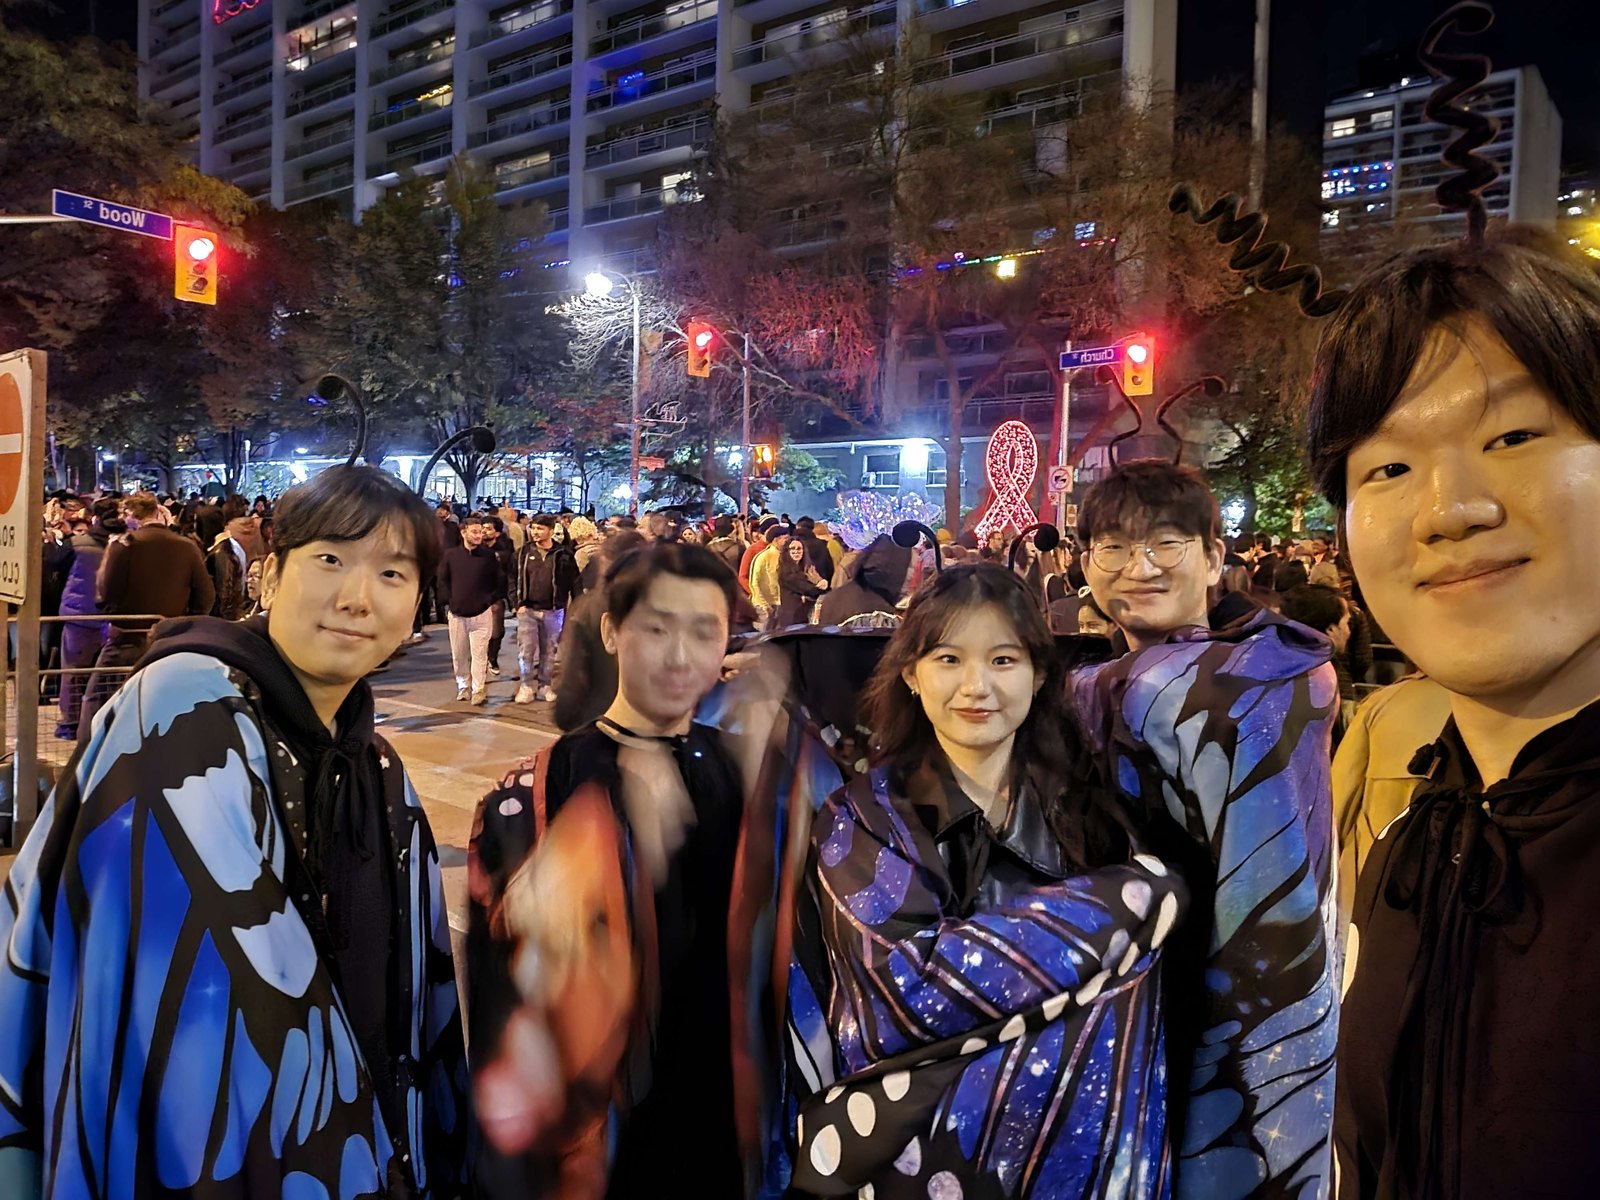
คืนฮาโลวีนที่โทรอนโต ทีมเราแต่งเป็นผีเสื้อกันทั้งทีม
▚ งานวิจัย ▞
เสียงและใบหน้ามาจากโมเดลตัวเดียว ตัวตนจึงไม่มีวันแยกออกจากกัน สาขาที่เราบุกเบิกด้วย JAM-Flow
มนุษย์แบบเรียลไทม์ที่เหมือนตัวจริงที่สุดในปัจจุบัน SoulX-LiveAct ทำให้คนเคลื่อนไหวได้ที่ 20 เฟรมต่อวินาที เสถียรต่อเนื่องได้เป็นชั่วโมง
การกลั่นโมเดล การทำ guidance และการสุ่มตัวอย่าง คืองานวิจัยที่ทำให้โมเดลดิฟฟิวชันเร็วพอจะใช้แบบเรียลไทม์ได้
การแก้ไขภายในโมเดลดิฟฟิวชันที่ฟรีซไว้ ตั้งแต่การค้นพบ h-space ไปจนถึงการคุมสไตล์และการลบข้อความบนจอ
อ่านฉากให้เข้าใจก่อนลงมือแก้ไข รู้ว่าใครกำลังพูดจากทั้งภาพและเสียงประกอบกัน ไม่ว่าในสภาพแวดล้อมแบบไหน


▚ ทดสอบด้วยคลิปชุดเดียวกัน ▞


สนับสนุนโดย


- Stanford
- Yonsei