每一句都听懂。你熟悉的表演,一分不少。
- 音乐与音效
- 人群与笑声
- 多人说话
- 空间推理
- 最高 4K
- 立体声与 5.1 环绕声


▚ 歌曲配音 ▞
音乐的一大突破。
情感。节奏。原样保留。
歌手本人的声音与口型,带进另一种语言。让你的专辑发行到全世界。
西班牙语译英语 | 两分钟片段
Will Smith《Beautiful Scars》 | 西班牙语配音版
THE RED PILL
VERSE 1 | WILL SMITH
CHORUS | OBANGA & BIG SEAN
VERSE 2 | BIG SEAN
CHORUS | OBANGA & BIG SEAN
VERSE 3 | WILL SMITH
CHORUS | OBANGA
- 01 / 03 | 0:13 处
牙齿和口型,三处都对上
这一帧里有两个人在说话:脸上的嘴唇和牙齿跟着西班牙语走,眼镜里映出的两个 Will 也一样。
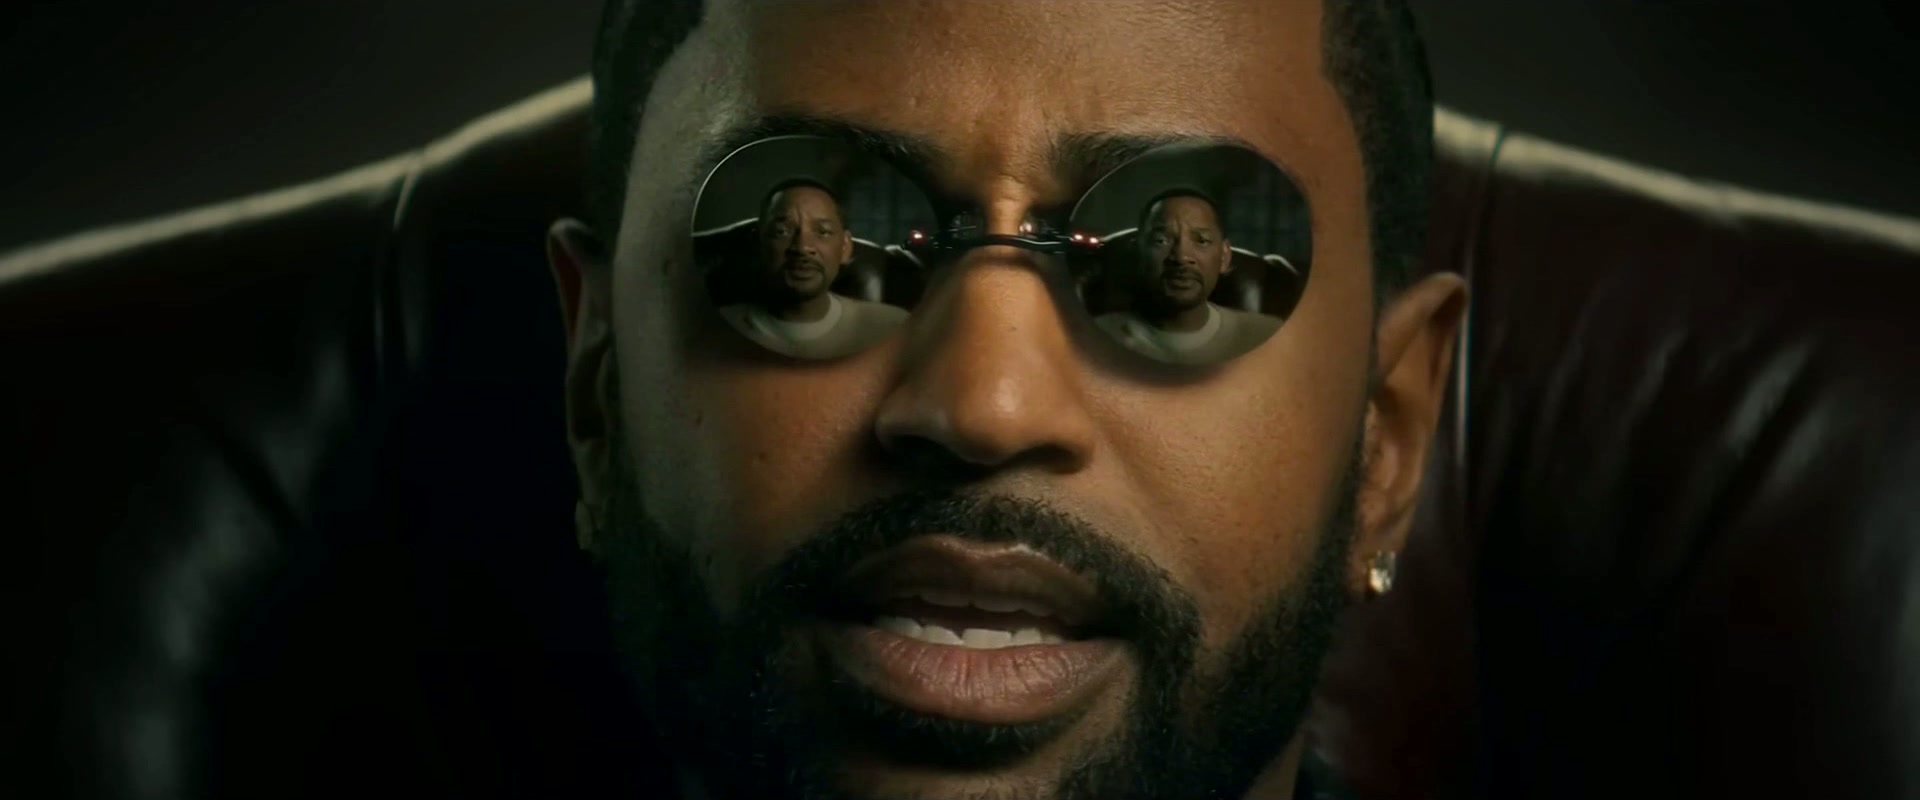 配音版 | 声音和口型译成西班牙语
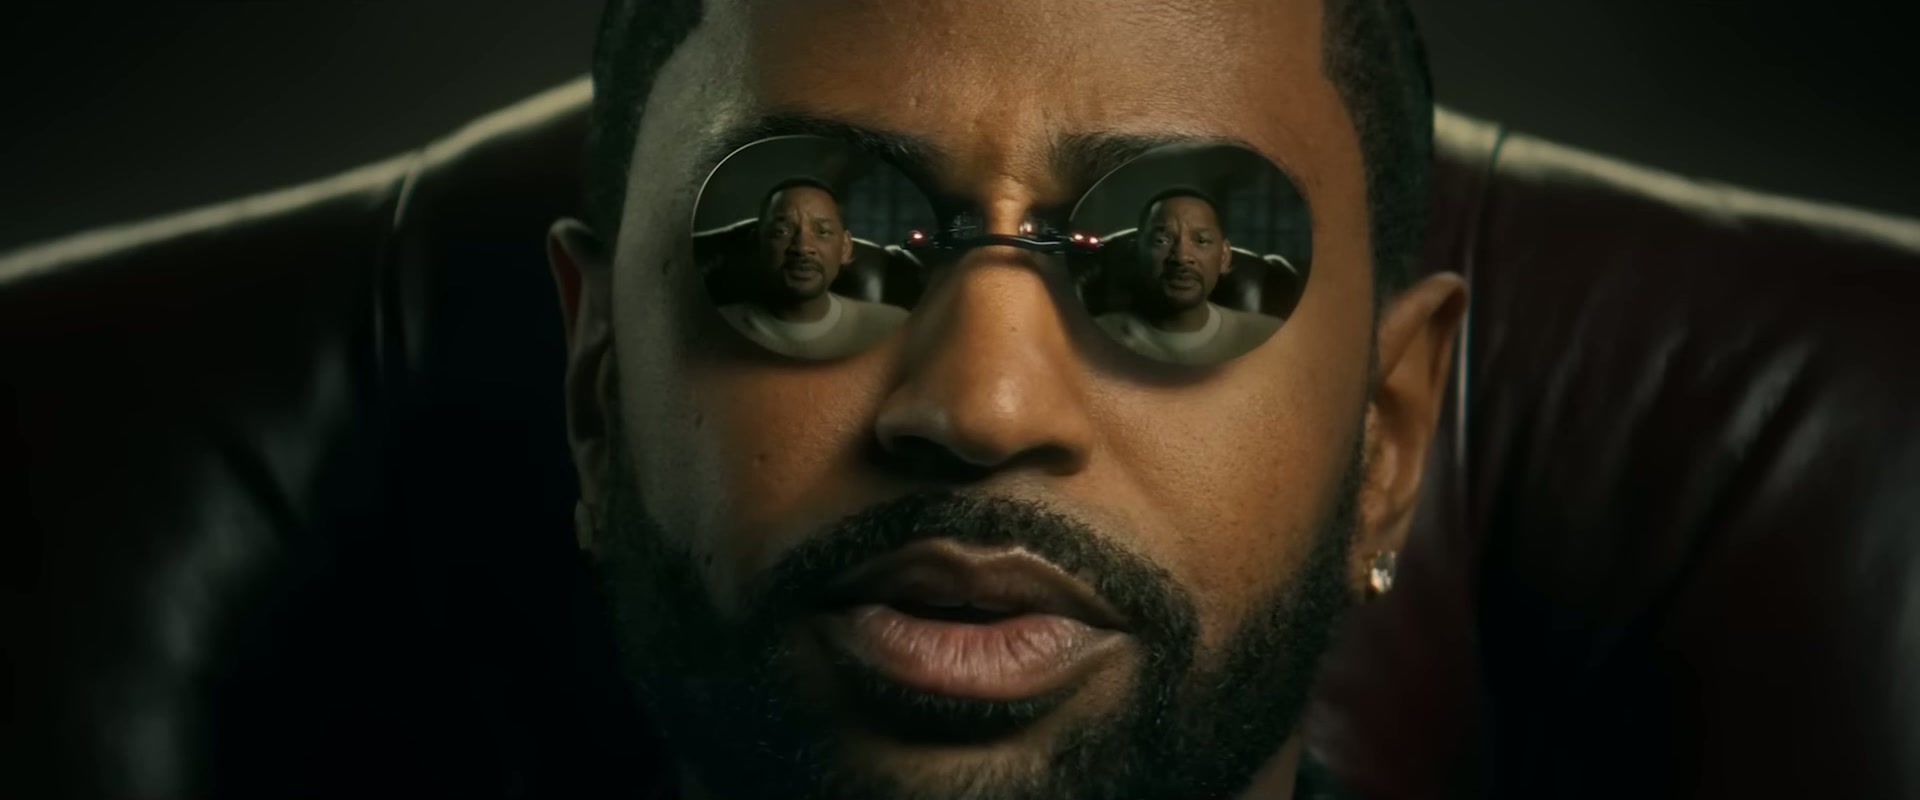 原版 | 英语,同一帧
- 02 / 03 | 2:30 处
鱼眼镜头下的空间推理
镜头把整张脸都拉弯了,后面那张脸还被一只手挡住,配音照样稳。
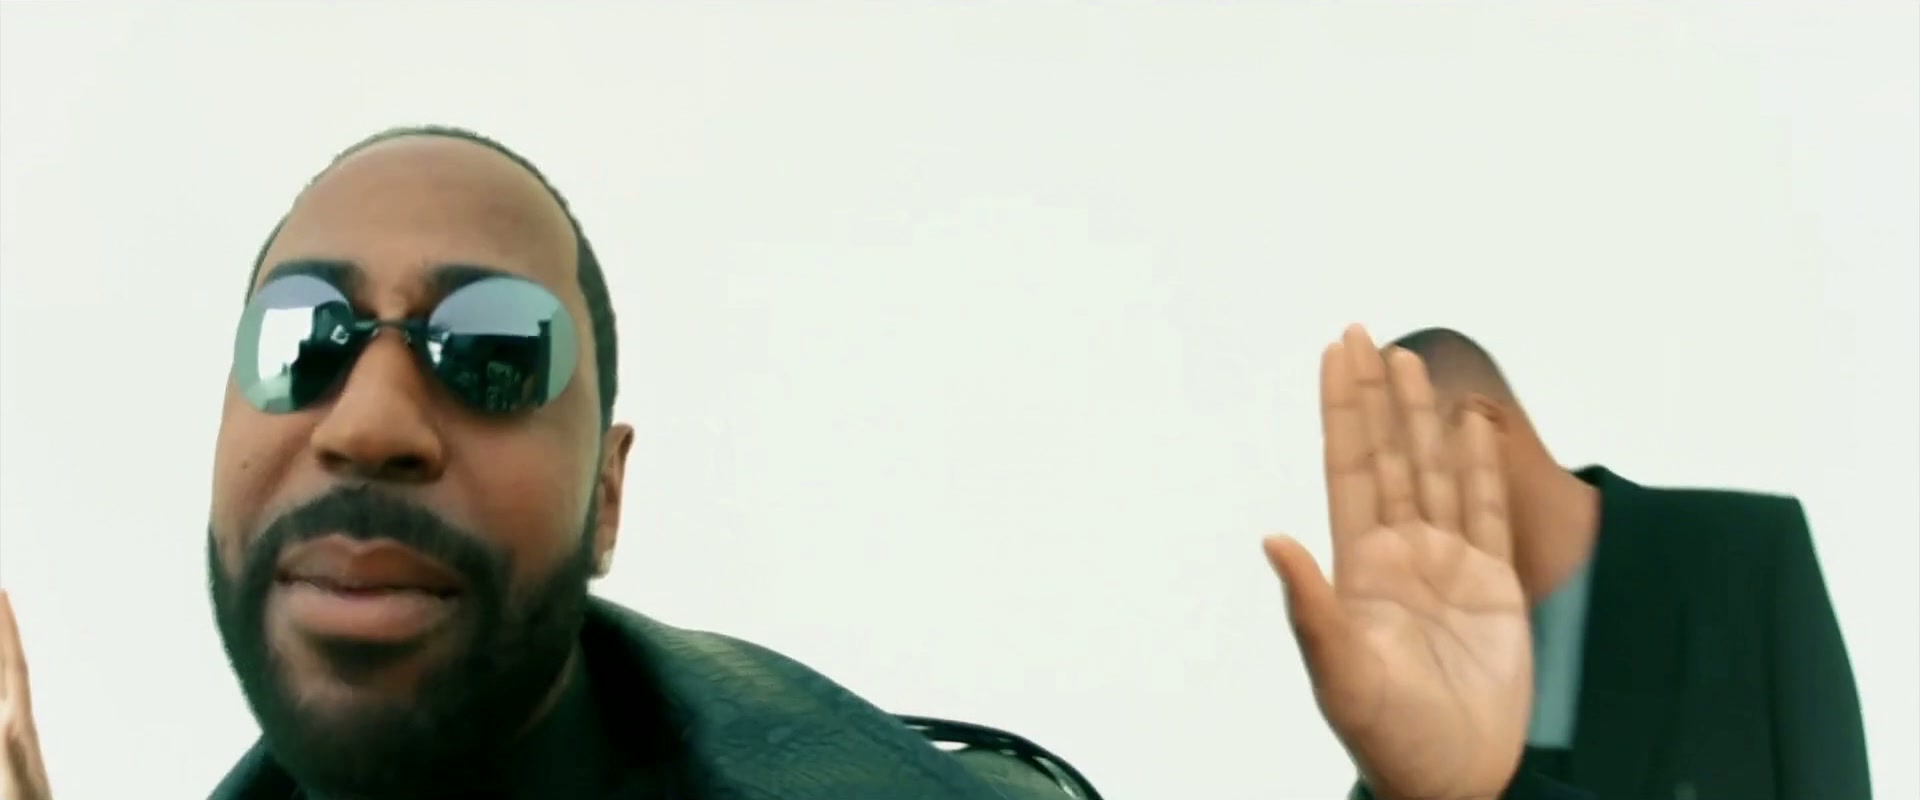 配音版 | 声音和口型译成西班牙语
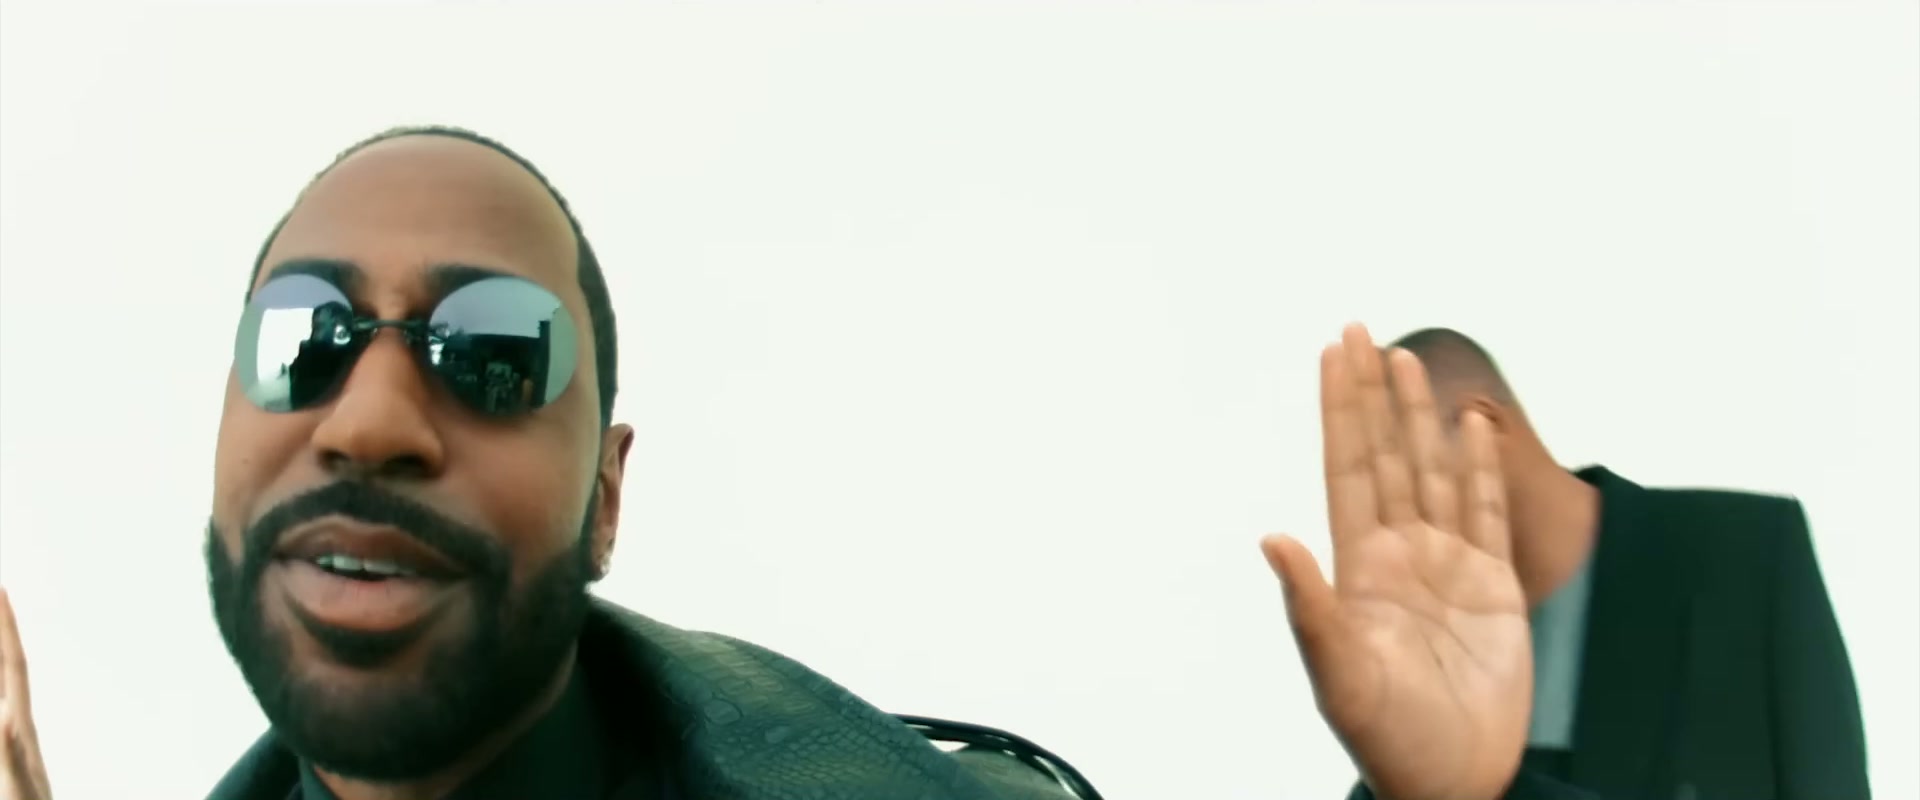 原版 | 英语,同一帧
- 03 / 03 | 3:40 处
运动模糊也对得上
唱到半句,镜头猛地一甩:嘴部的模糊和画面其余部分完全一致。
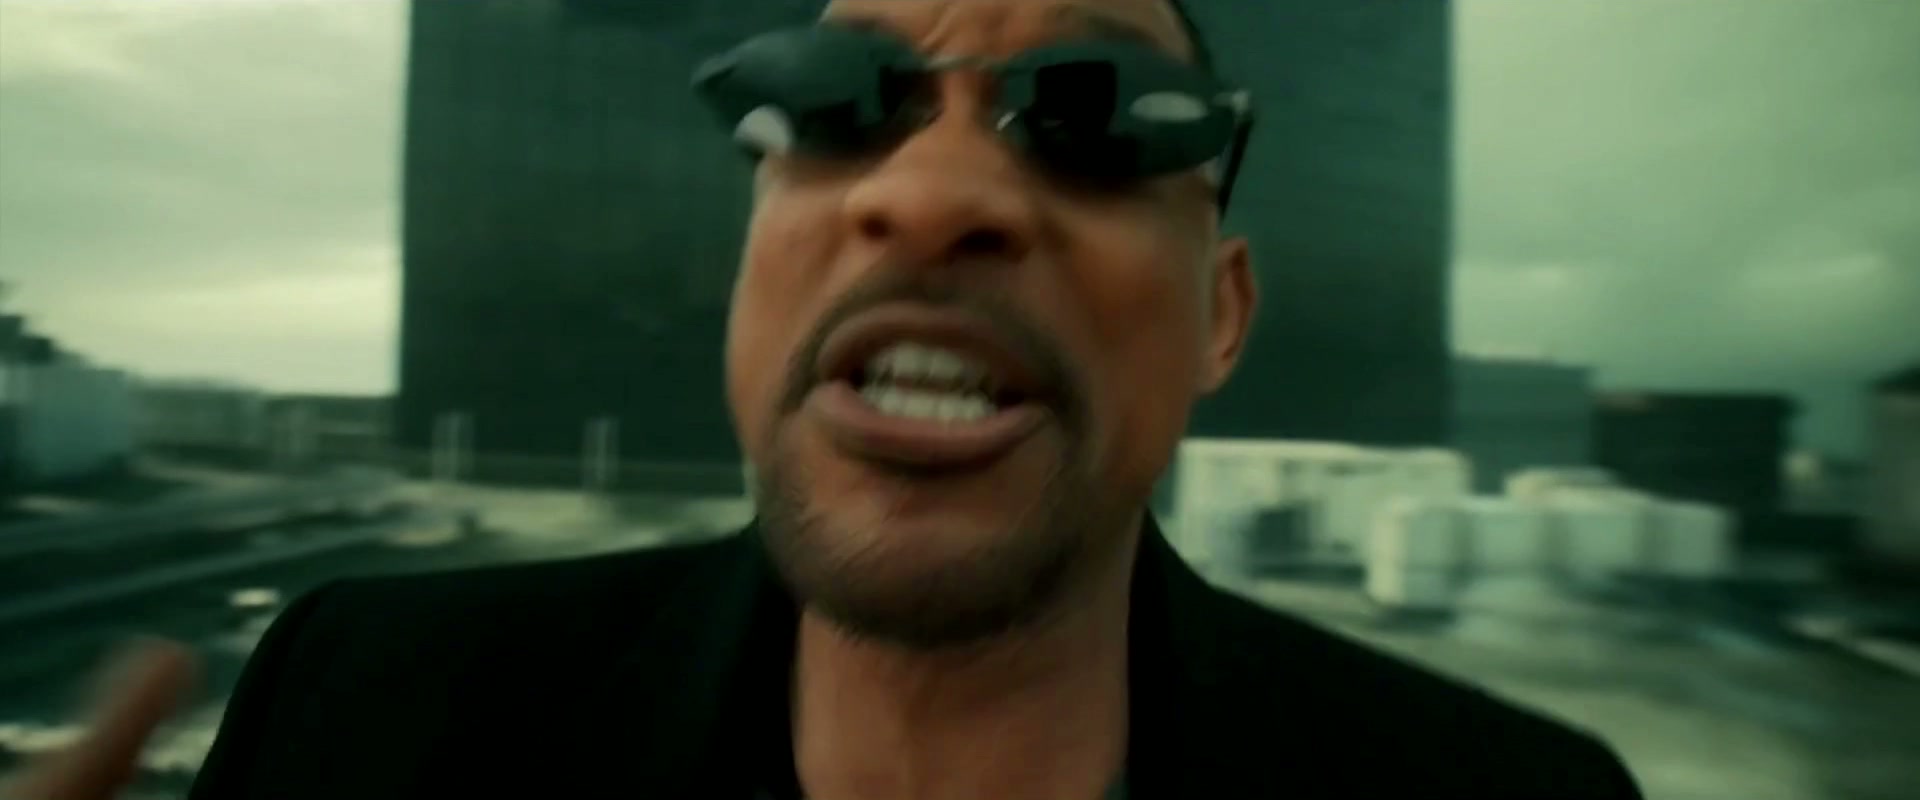 配音版 | 声音和口型译成西班牙语
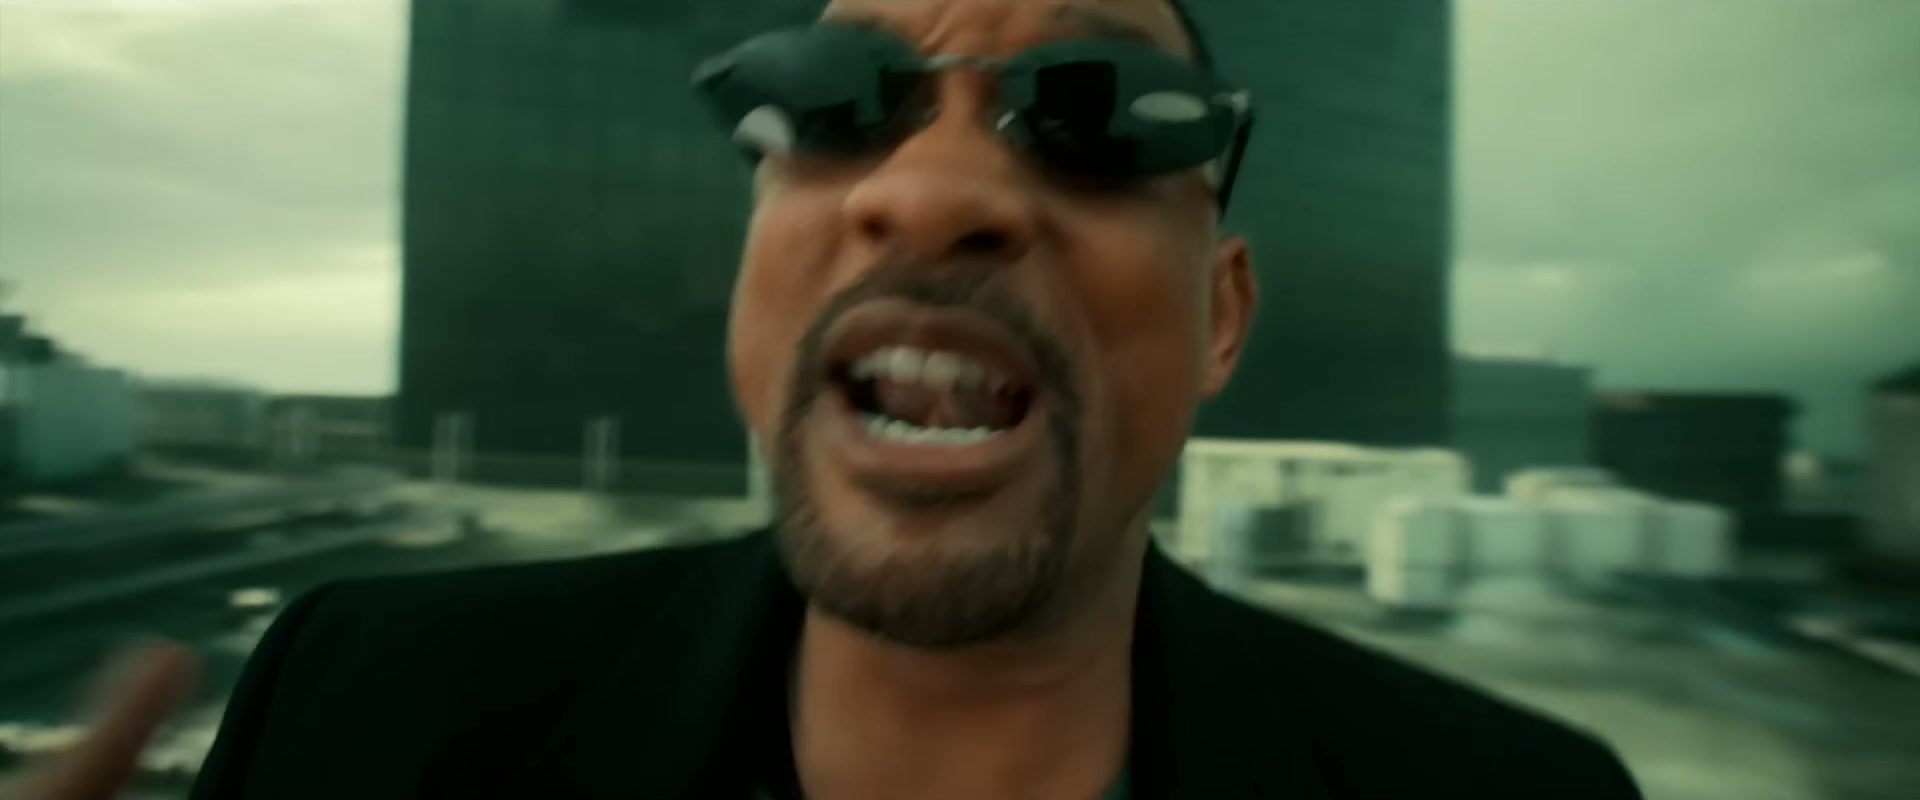 原版 | 英语,同一帧
表演保留得这么完整,连歌曲换成另一种语言,也一样成立。
 Jibin Song首席科学家团队 →
所以无论歌曲出现在哪里,都能一并本地化:
- 动画电影
- 少儿内容
- 音乐剧
- 影视剧里的歌曲
- 主题曲与片头曲
- 专辑与 MV
23×
作品做了视觉配音后,流媒体观看时长的增幅。
对比同一作品的纯音频配音
真人配音的极限
- 失去原版演绎
- 难以规模化
- 成本高昂
- 现有 AI 还不到位
▚ 一气呵成,不必数周 ▞
先定翻译,再一气呵成做出配音:
 Familiar Labs
 Flawless
 HeyGen
 ElevenLabsFamiliar LabsFlawlessHeyGenElevenLabs
如今业内用的辅助工具,每个项目都需要一支视效团队忙上数周,而且每种语言都是一个新项目。
如今的一键式工具,快是快,其余的却都放弃了:译文改不了,音乐和现场环境音消失,声音跑偏;手挡在脸前、麦克风、虚焦、焦外虚化、侧脸,或者画面里有好几个人,口型就对不上。没有空间推理,不理解真实世界,也无从掌控。
Familiar Labs 对比 Flawless TrueSync →投资方


 Stanford
 Yonsei

不是“生成式 AI”,而是助力创作者的翻译。
从人到人,不是从 AI 到 AI →“生成式 AI 是人工智能的一个分支,根据用户的提示词创作原创内容,比如文本、图像、视频、音频和软件代码。”

把繁琐的活儿交给 MLFM。
没有提示词,也不随机生成新东西。
从人到人,让同一段表演走得更远。
我们训练用的所有数据,其实都出自 Familiar Labs 团队之手。

一个模型,决定本地化什么、怎么本地化,覆盖文本、音频和画面,并把关键的选择摆到你面前。

每句台词用哪种译法。
- 权衡多种译法;创意总监能看到每个选项和背后的理由,再做选择。
- 哪些不用翻译:俚语照原样保留,名字和品牌保留不译。
- 典故换成观众熟悉的,避开当地文化的忌讳,面向低龄观众的版本把脏话调轻。
哪些该翻译。
- 找出主要的那个声音,用说话人自己的声音说出来。
- 笑声、人群、一声大喊、听不清是谁在说的话:原样保留。
- 一段口号、一声呐喊、一句话,保留原语言。
画面上该本地化什么。
- 到底是谁在说话:谁在旁白,谁在画外发声。
- 口型,包括遮挡与空间推理。
- 在需要强调或文化有讲究时,表情和手势也跟上。
- 画面里的文字,比如手机屏幕、书的封面、路牌、店招,沿用你已定下的译法。
- 哪些保持拍摄原样,当场决定:一袋 Tostitos 还是 Tostitos。
- 一句台词属于哪张脸,哪些文字要翻译。
每个决定都会随这次配音任务一并记录。任何一项你都可以改,一次定下的选择,下一集也会沿用。
什么是 MLFM?▚ 同一批片段实测 ▞
基准测试
遮挡与空间推理:麦克风挡在嘴前,手从脸前划过,配音照样稳。

▚ API ▞
你的平台,说每一种语言。
review=manual创意总监先审核,再发布
- 能听出不止一种意思的台词,比如一个笑点、一句挖苦,会返回三版译文,意图和情绪各不相同。
- 你的创意总监选定一版。
- 对照原文编辑任意一行,再触发配音。
- 1Apples. I'm sorry, right down to the core.保留双关 · 不好意思
- 2I came to say sorry. I brought apples.保留原意 · 真诚
- 3An apple a day keeps the silent treatment away.另造新梗 · 俏皮
- 1Wow. You're incredible.真诚 · 温暖
- 2Well, aren't you something.反讽 · 冷幽默
- 3Look at you, hotshot.调侃 · 俏皮
/v1/dubs/dub_31xk9m/render- 翻译00:12.4seg_12 · 사과하려고 사과 사 왔어.Apples. I'm sorry, right down to the core.I came to say sorry. I brought apples.An apple a day keeps the silent treatment away.创意总监拍板EDITED
- 音频00:41.2 – 00:44.0Crowd chantKeep in KoreanTranslate修改
- 画面00:58.0Phone screen · 내일 봐See you tomorrowKeep as shot修改
- 画面01:12.6SpeakerSpeaker 1Speaker 2Speaker 3修改
/v1/dubs/dub_31xk9m/decisions/GET /v1/dubs/{dub_id}/decisions决策记录:看得到,改得了。
现在,你的创意总监就能看到每种译法和背后的理由。音频和画面的决定正在研发中:一段保留原语言的口号、一句台词属于哪张脸、手机屏幕上的文字。
查看文档 →推理跑在自己的 GPU 上:就在多伦多,不上公有云。
每一条配音都在我们自有的、价值八位数美元的 NVIDIA B300 GPU 集群上处理,用的是市面上最强的 GPU,就在加拿大多伦多。你的素材从不在 Google Cloud、AWS 这类公有云上处理,也不经第三方推理服务商之手,因此绝不会外泄。
查看文档 →- GPUS
- NVIDIA B300, the best on the market
- CLUSTER
- Eight figures, USD
- LOCATION
- Toronto, Canada
- OPERATOR
- Familiar Labs, on compute we own
- PUBLIC CLOUD
- None
- THIRD-PARTY INFERENCE
- None
▚ 支持语言 ▞
13种语言,任意互译。
用自己的声音和口型,触达每一位观众。
输入与输出13
- 阿拉伯语
- 德语
- 俄语
- 法语(法国)
- 韩语
- 葡萄牙语(巴西)
- 日语
- 泰语
- 西班牙语(拉丁美洲)
- 意大利语
- 印地语
- 英语
- 中文
▚ 安全 ▞
在你的电脑上密封,只在多伦多打开。
你的内容绝不会被用于训练。
密封上传
文件离开你的网络之前就在你的电脑上加密,传输途中即使被截获也无法读取;配好的成片也以同样方式密封送回。
多伦多的自有服务器
在我们位于加拿大多伦多的自有算力上处理和存储;不用公有云,也不经第三方推理服务商之手。
最小权限
解密密钥由两位指定负责人保管;除我们指定的安全角色外,任何人都无法打开你的内容。
按期删除
配音一交回即删除(零数据保留),或在你验收后删除,或在交付 14 天后自动删除。
TPN+ 成员 | MPA 内容安全最佳实践
适用于签有合约的影视公司、流媒体平台和唱片公司项目。

有疑问?
配音迎来代际飞跃:你的声音与口型,带进新的语言;把 ElevenLabs 和 HeyGen 拼在一起用,听起来、看起来仍然像另一个人。这不只是 AI 对口型:整张脸都在演绎新的语言,遮挡与空间推理也包括在内。
在我们公开发布的基准测试中:
- 他们的最新产品背景音错误多出270%:笑声、音乐、环境音
- 我们的重大翻译错误比他们的最新产品少54.7%
- 在他们的 Dubbing v1 上,我们的音色还原度高出27.8%,全部11种语言都更接近说话人本人
在同样的片段上,ElevenLabs:
- 漏词或凭空添词45次
- 笑声和音效破碎8次
- 说话人的声音跑偏6次
- 几个人同时说话时声音打架6次
- 语气被压平4次
- 现场环境音被抹掉4次
- 它的 API 拒绝处理不足11秒的片段
自己拼一套,每分钟 $11:Sync.so 的口型同步 $8,加上 ElevenLabs 的音频 $3。Familiar Labs 的一条配音就包含声音、口型和翻译,交付最高 4K,原生 5.1 环绕声或立体声混音。