团队
博士与研究者
 Stanford
 Yonsei

我们的使命,是打破阻碍理解的每一道壁垒。
想象这样一个世界:我们看的、听的所有内容,无论换成哪种语言都天衣无缝。爸妈和家人爱听的那些歌,我们终于能听懂了;我们最爱的英文歌,也有了韩语版和中文版,让他们听得懂,也会一起听。英语观众能看到韩国、中国乃至世界各地最好的内容;其他所有人看英语内容,也不再需要字幕。
这些翻译过来的歌,我想加进自己的歌单。
 Andrew LiuCEO从人到人,不是从 AI 到 AI →
Andrew LiuCEO访问审批人
团队里不少人的英语,都是看电视学来的。我们的 CEO Andrew Liu 当年没法用英语和同学交流,一个朋友也没有,整所学校只有他一个亚洲人;他是看电视学会英语的,这段经历他从未忘记。
这就是 Familiar Labs 存在的原因:让屏幕上播放的一切,都能用每个人听得懂的语言抵达他们。

Jibin Song首席科学家第二密钥保管人 | 变更审批人


Michael ChanCBO事件响应负责人
Taehwan Lee技术团队成员
Tonghyun Lee技术团队成员


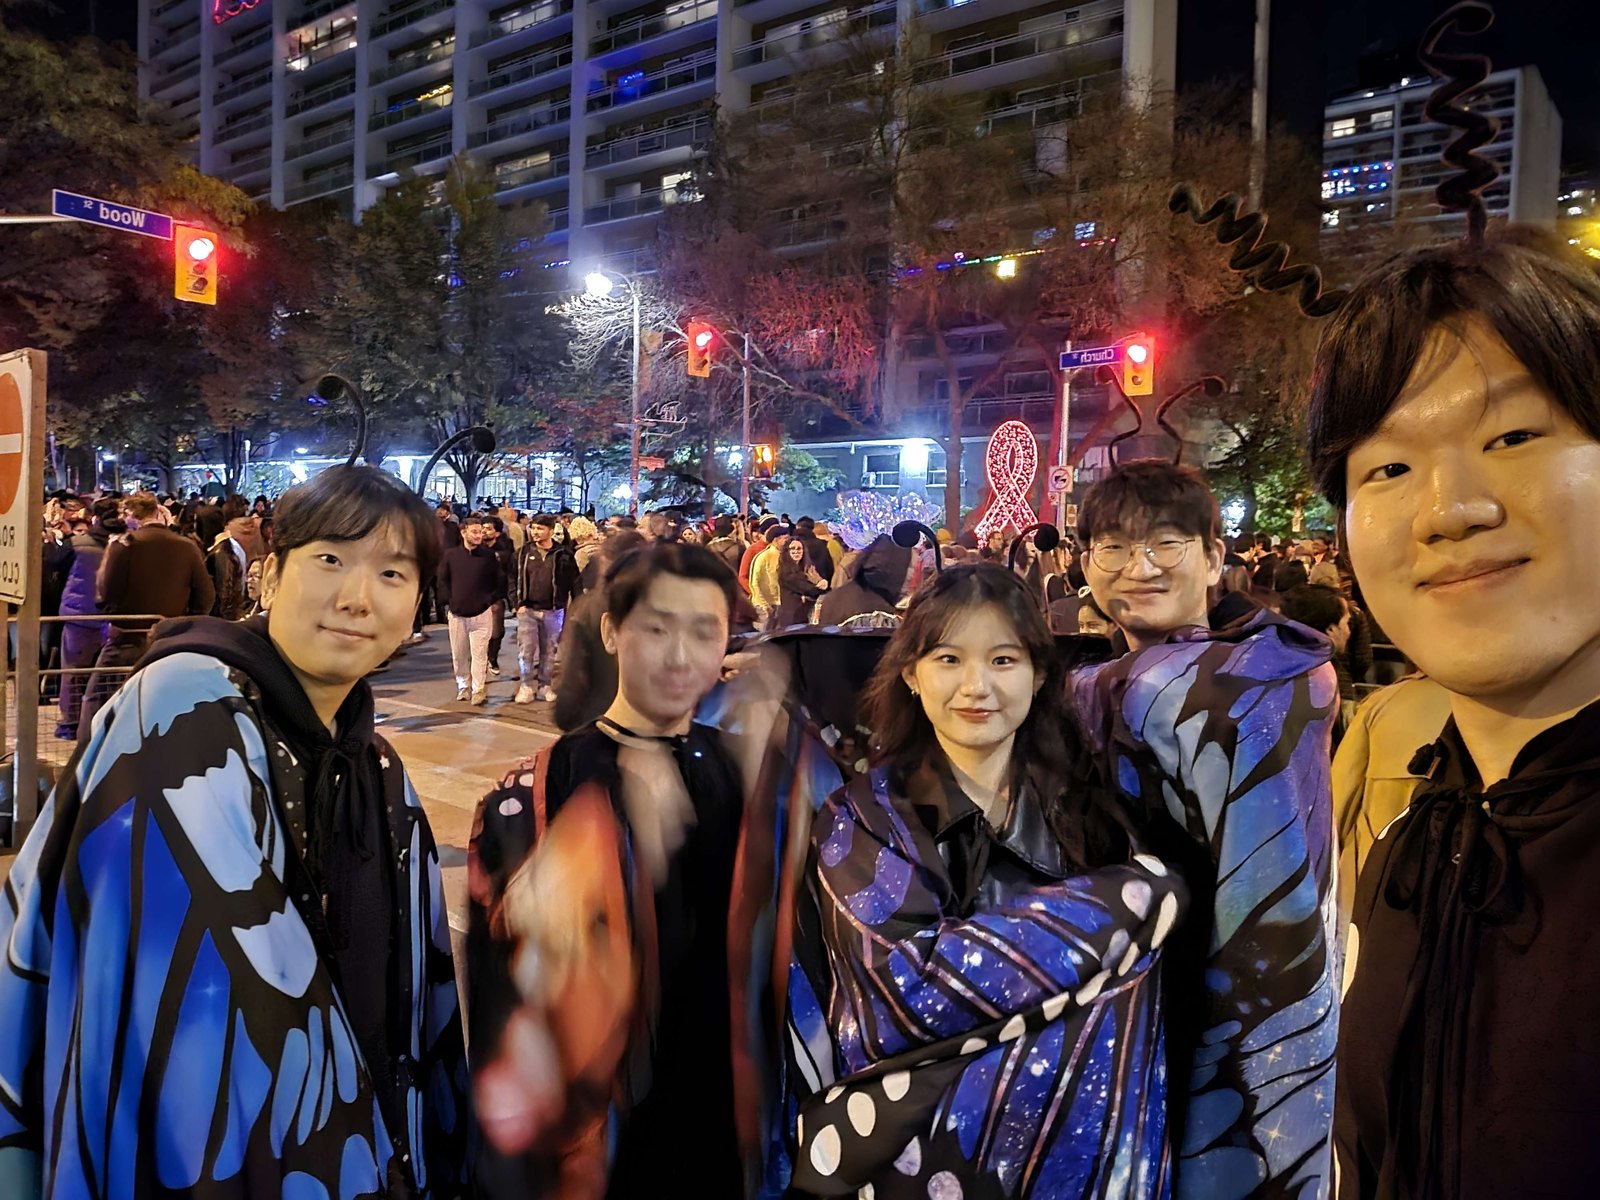
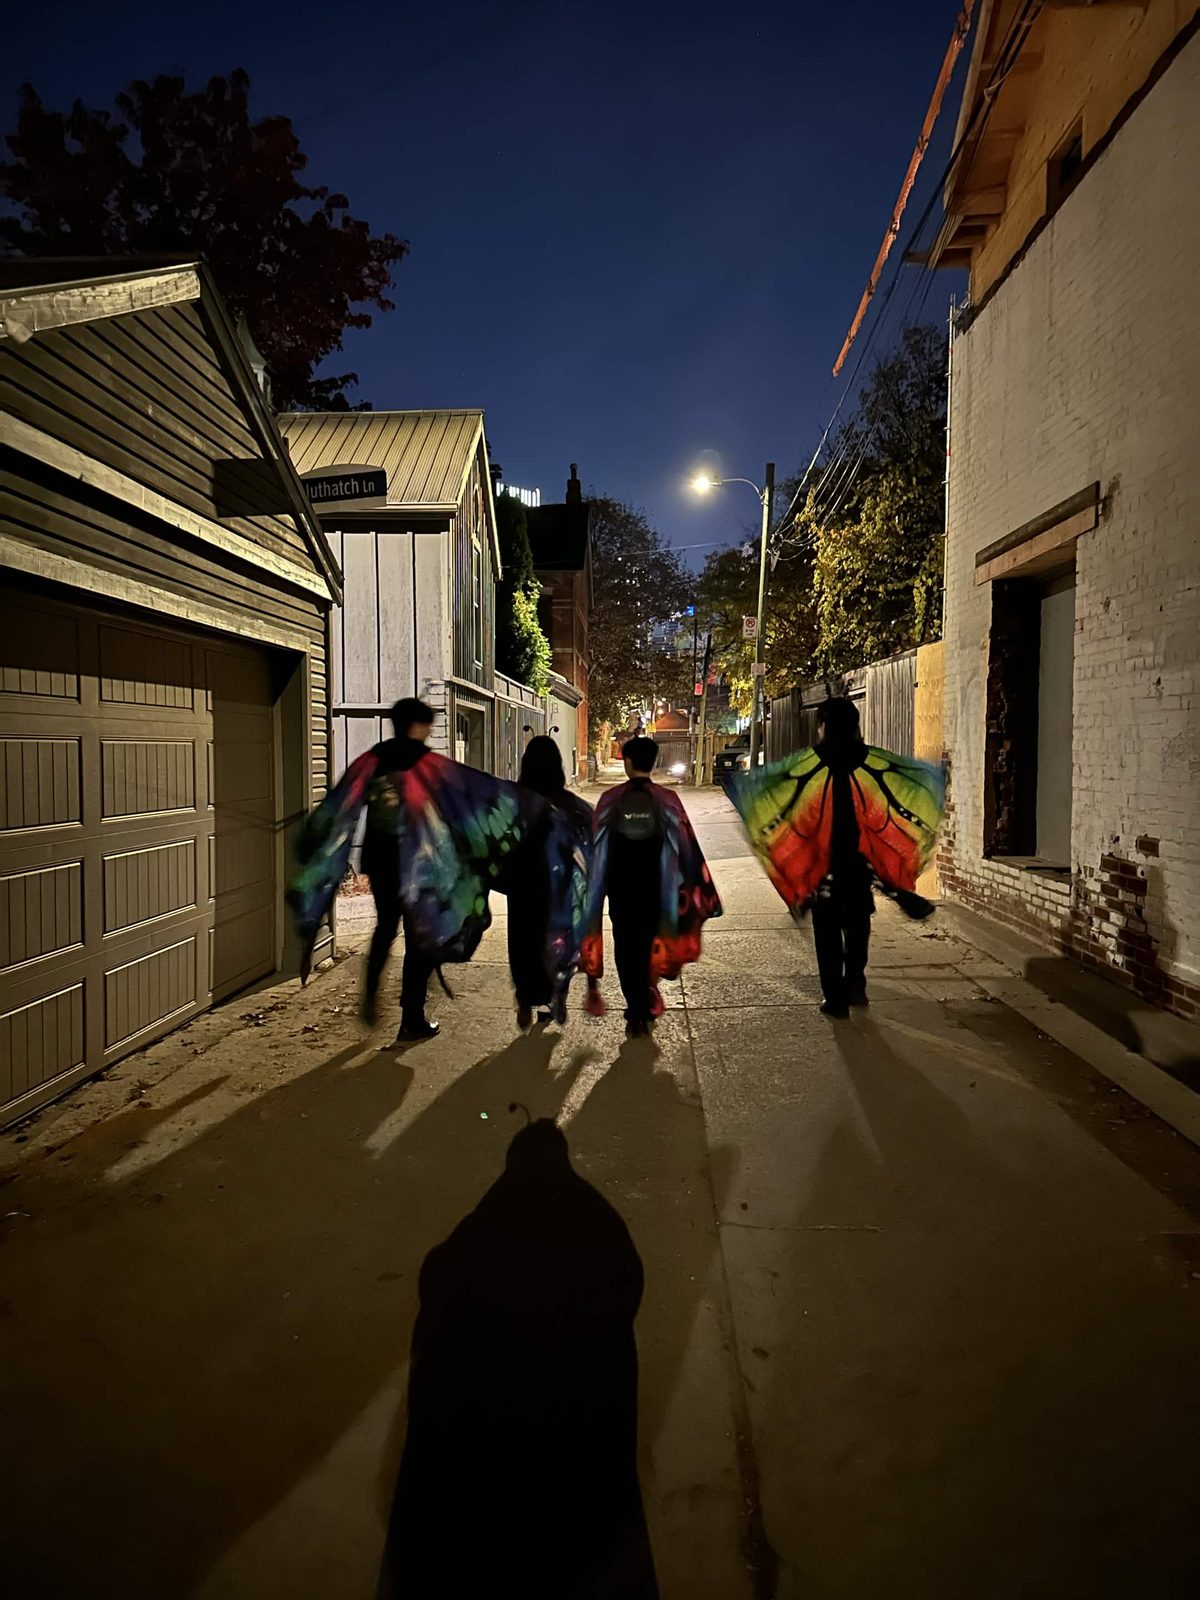
▚ 万圣节 2026 ▞
多伦多的万圣节之夜,整个团队都扮成了蝴蝶。
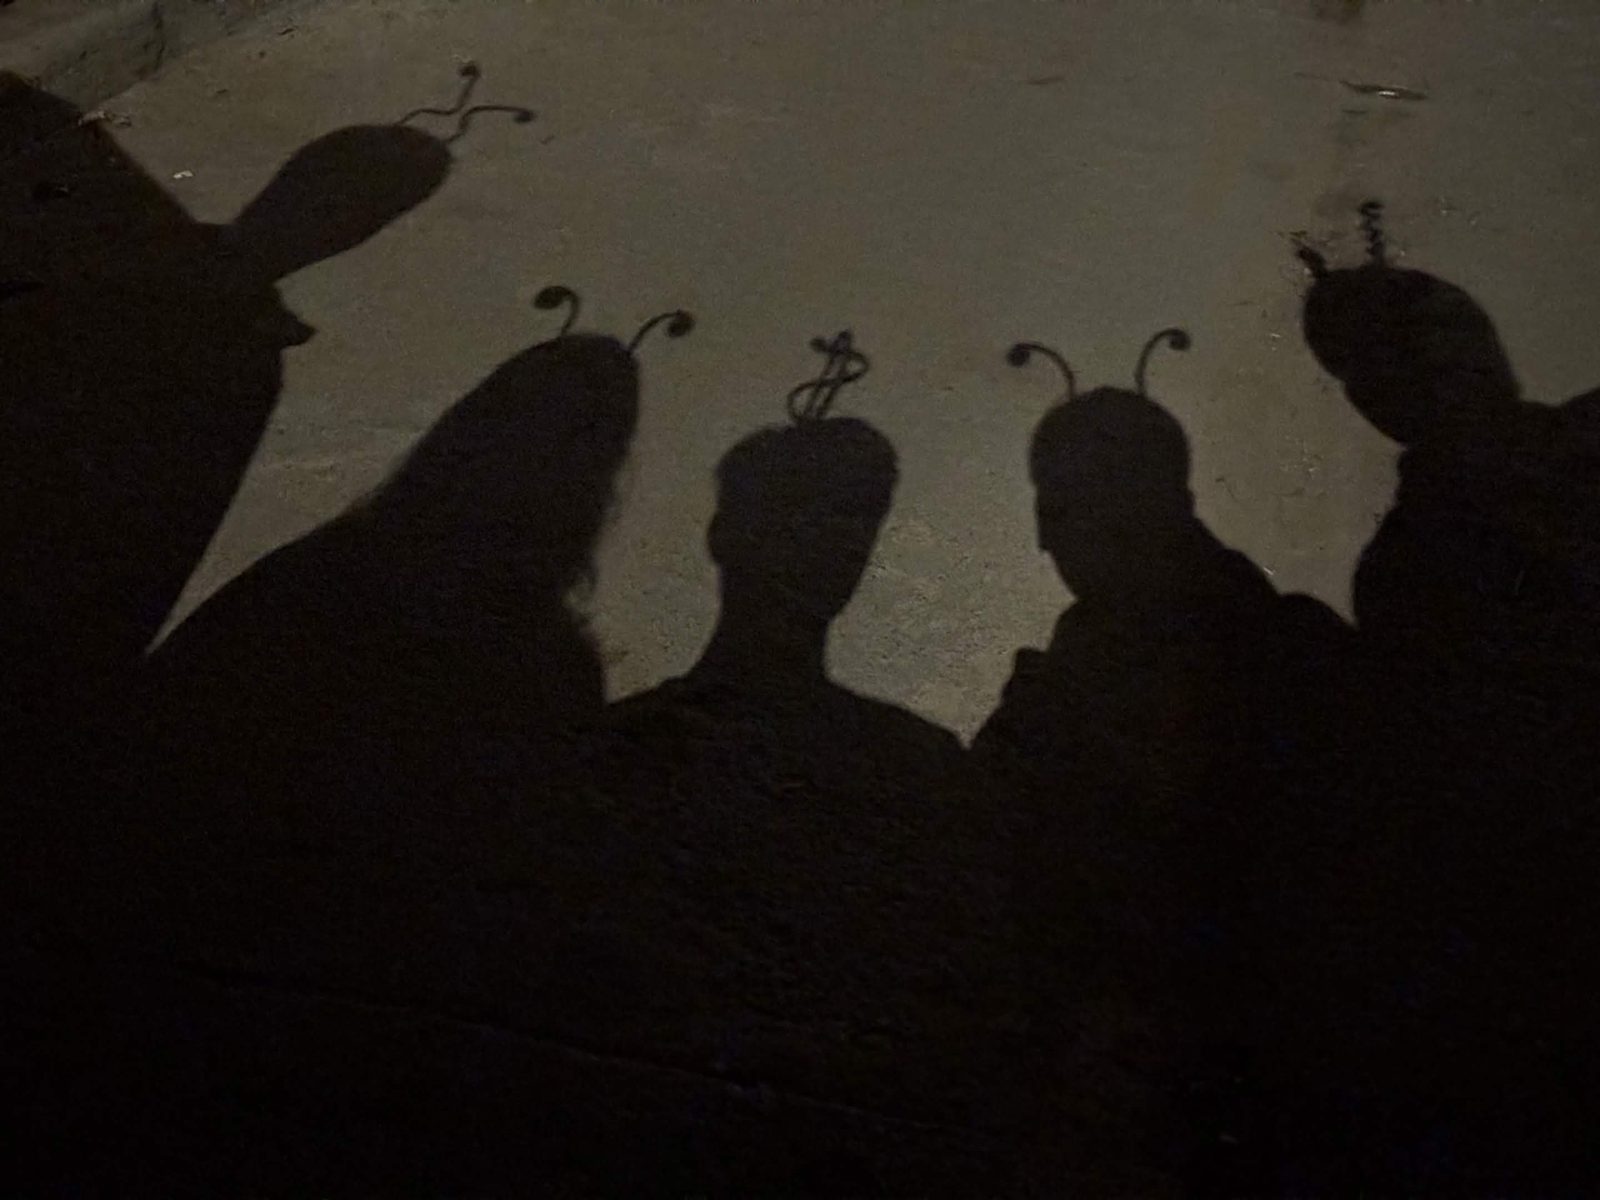
▚ 研究 ▞
音视频联合生成
声音与脸出自同一个模型,身份永远不会割裂:这个领域由我们以 JAM-Flow 开创。
实时人像动画
当今最逼真的实时人像动画:SoulX-LiveAct 以每秒 20 帧驱动人像,可稳定运行一小时。
快速视频生成
蒸馏、引导与采样:让扩散模型快到足以实时运行的研究。
扩散模型内的编辑
在冻结的扩散模型内部做编辑:从发现 h-space,到控制风格、抹去画面文字。
多模态感知
2021 年以来,被引用超过 10,000 次,在 ICLR、NeurIPS、CVPR、ECCV 等顶会发表论文 100 余篇。先读懂场景,再动手编辑:在任何环境里,结合画面与声音判断谁在说话。


投资方


- Stanford
- Yonsei