Localizzazione multimodale al servizio dei creativi.
Il doppiaggio, finalmente fatto bene.
Con Familiar Labs, la stessa interpretazione per ogni pubblico.
Capisci ogni parola. Con Familiar Labs, l'interpretazione resta intatta.
- Musica ed effetti sonori
- Folla e risate
- Più voci
- Ragionamento spaziale
- Fino al 4K
- Stereo e surround 5.1


▚ SONG DUBBING ▞
Una svolta per la musica.
EMOZIONI. RITMO. INTATTI.
La voce e le labbra del cantante, portate in un'altra lingua. Pubblica il tuo album in tutto il mondo.
Dallo spagnolo all'inglese | un estratto di due minuti
Will Smith, Beautiful Scars | doppiata in spagnolo
THE RED PILL
VERSE 1 | WILL SMITH
CHORUS | OBANGA & BIG SEAN
VERSE 2 | BIG SEAN
CHORUS | OBANGA & BIG SEAN
VERSE 3 | WILL SMITH
CHORUS | OBANGA
- 01 / 03 | Al minuto 0:13
Denti e labbra, su tre volti
In questa inquadratura parlano due persone: labbra e denti seguono lo spagnolo sul volto e su entrambi i riflessi di Will negli occhiali.
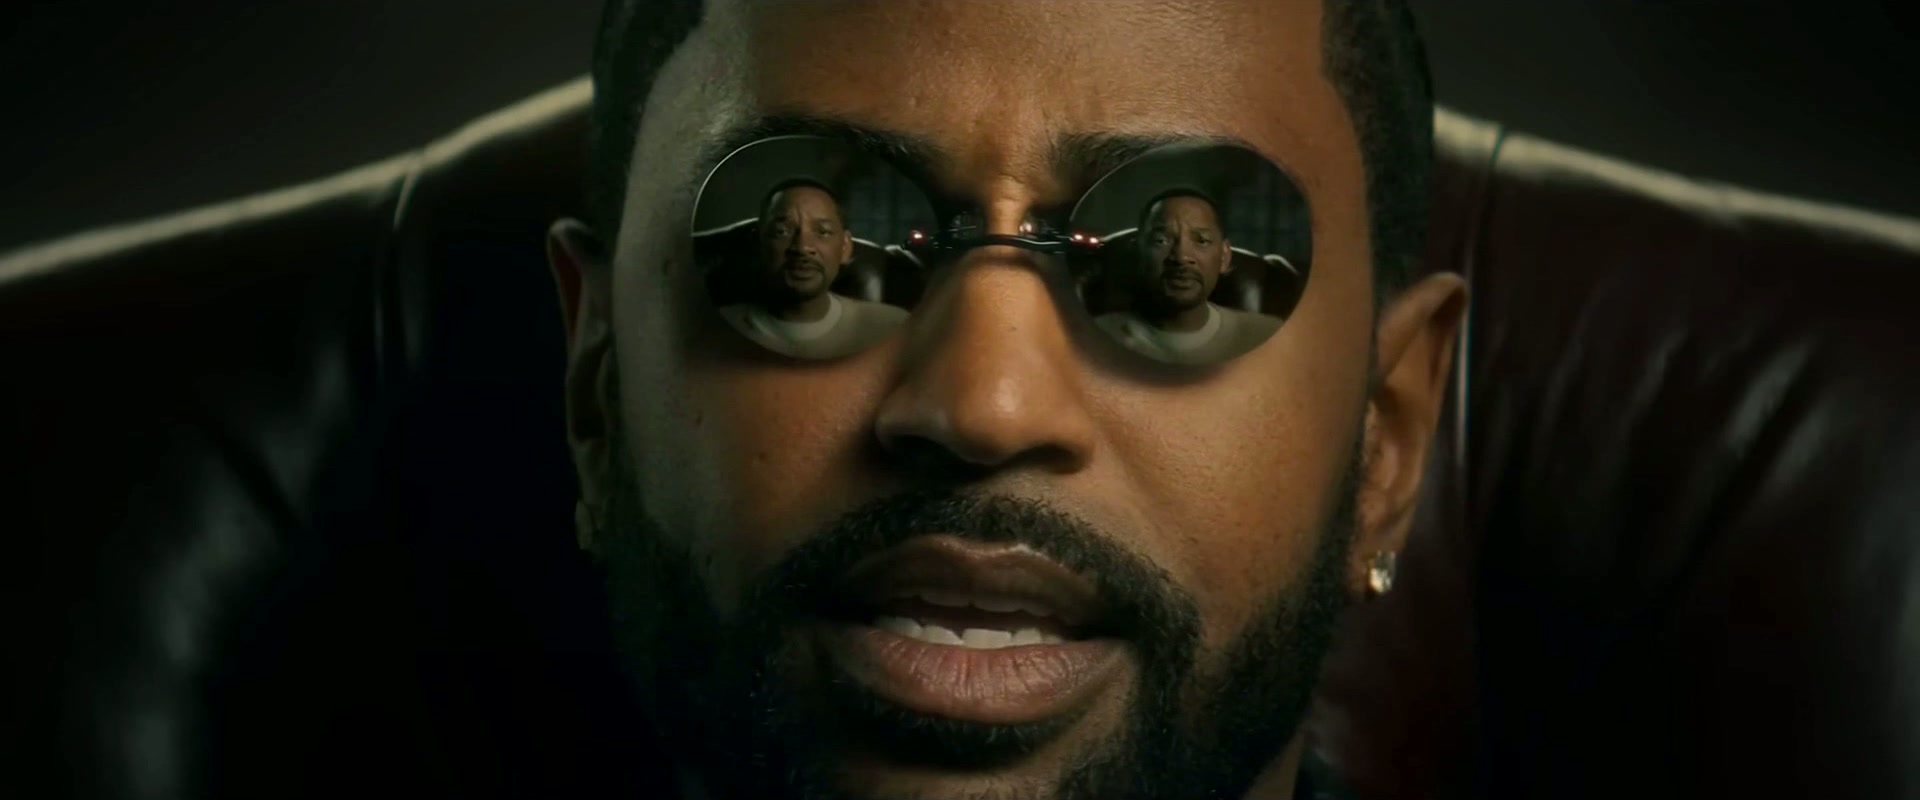 Doppiato | voce e labbra tradotte in spagnolo
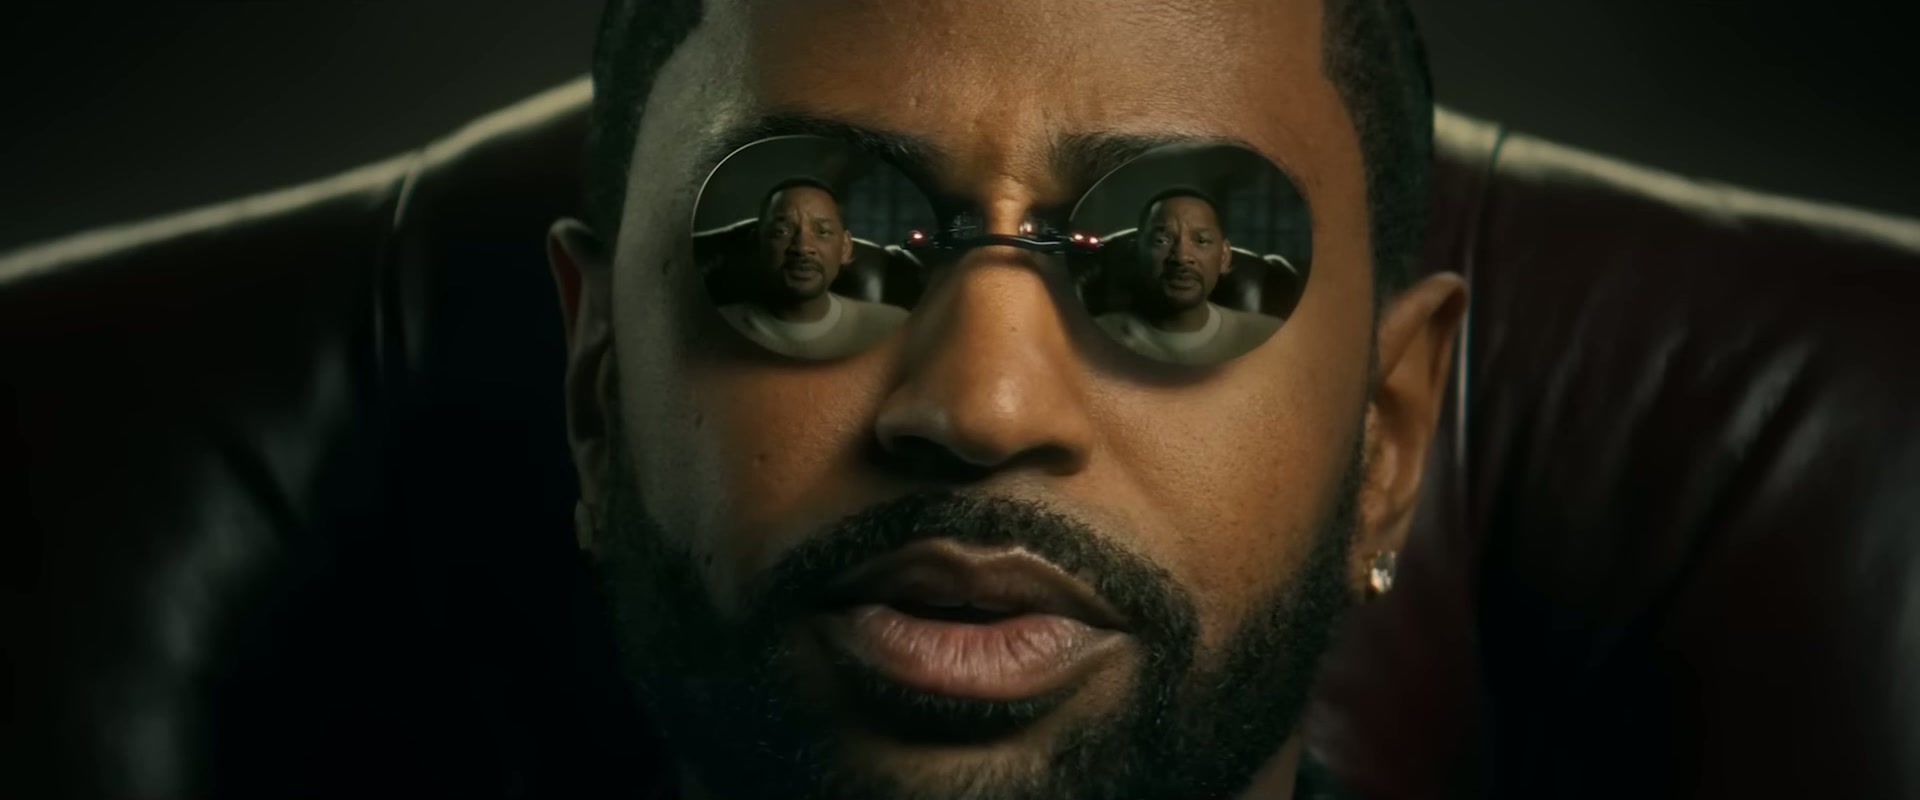 Originale | inglese, la stessa inquadratura
- 02 / 03 | Al minuto 2:30
Ragionamento spaziale attraverso un fisheye
La lente deforma tutto il volto e una mano copre quello dietro; il doppiaggio tiene.
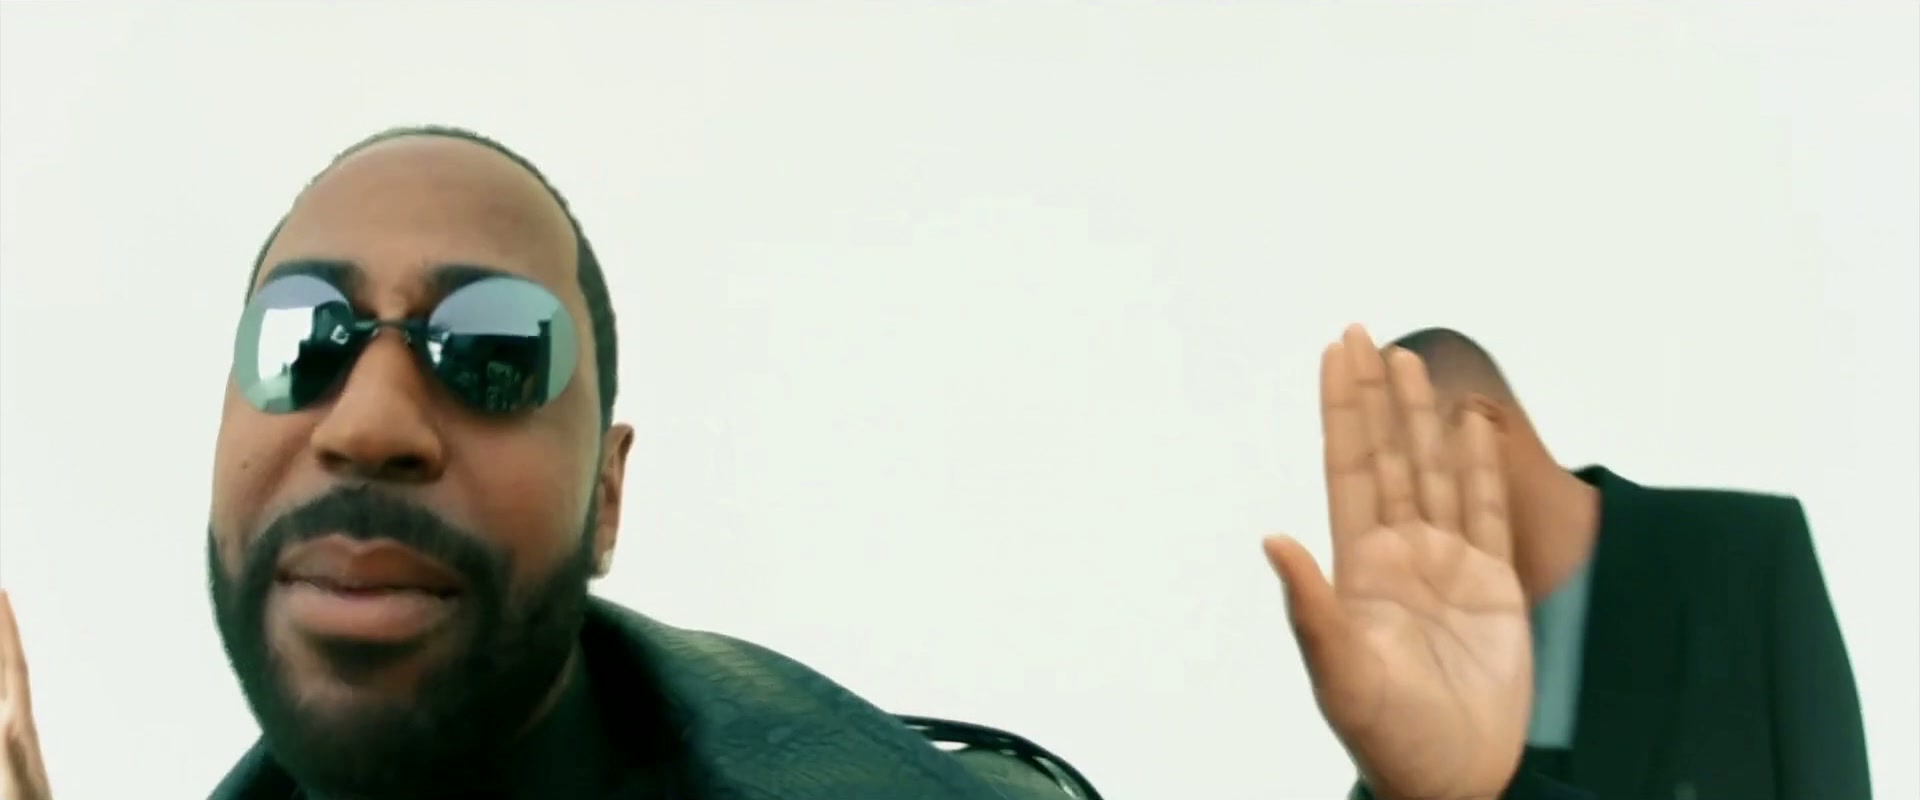 Doppiato | voce e labbra tradotte in spagnolo
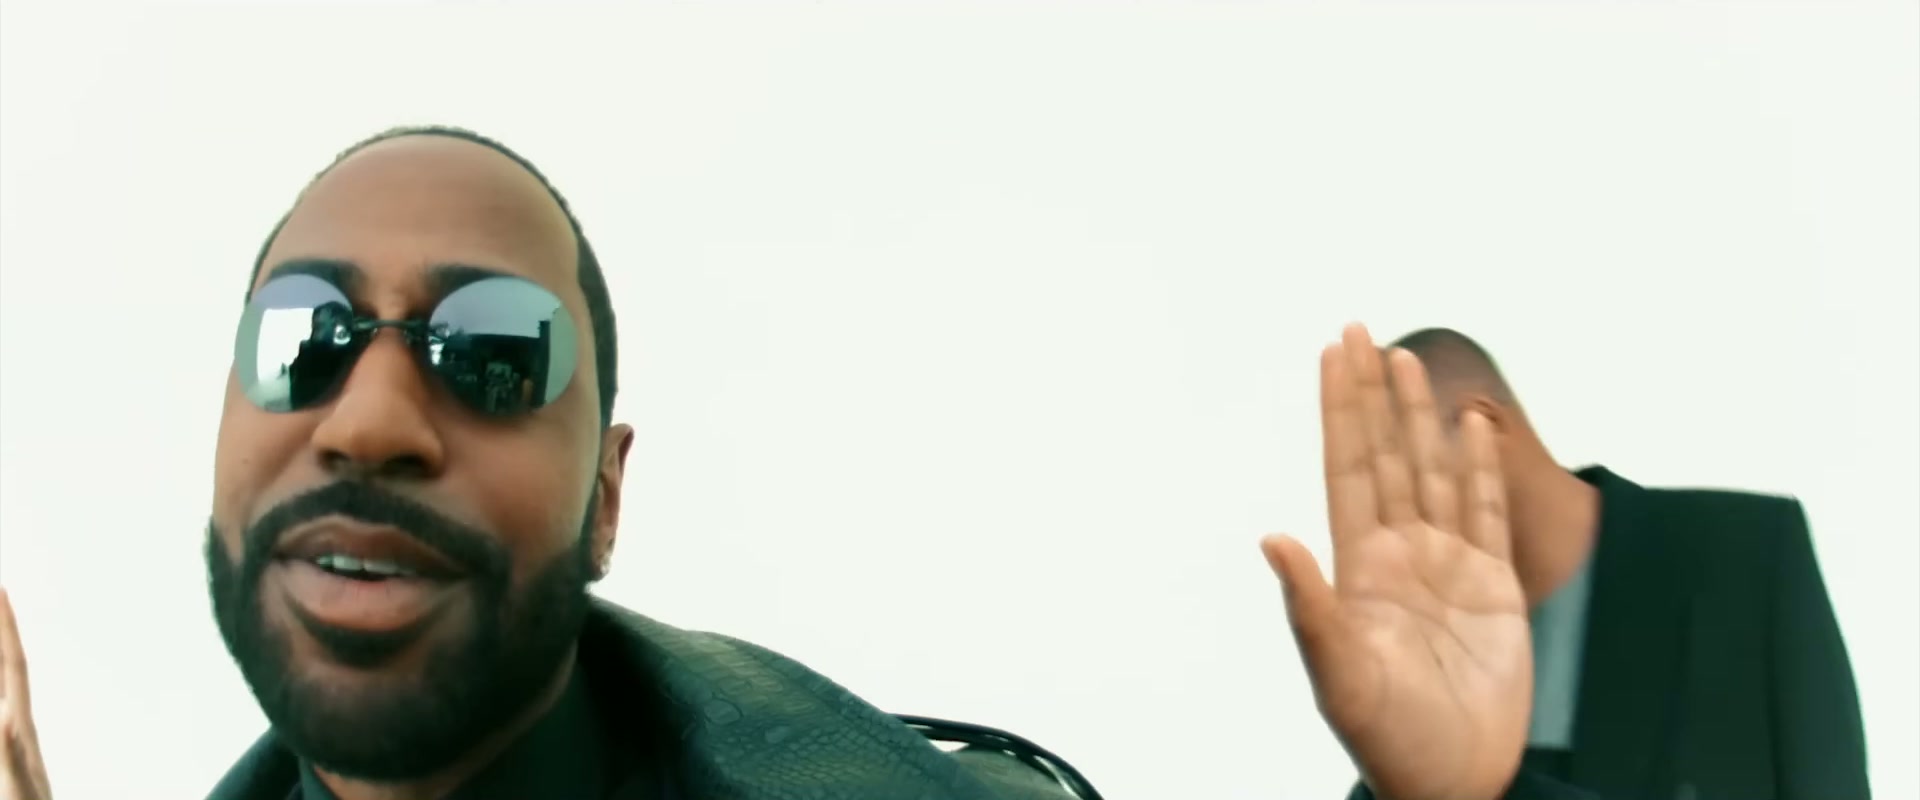 Originale | inglese, la stessa inquadratura
- 03 / 03 | Al minuto 3:40
Lo stesso motion blur
Una panoramica a schiaffo a metà verso: la bocca ha lo stesso mosso del resto dell'inquadratura.
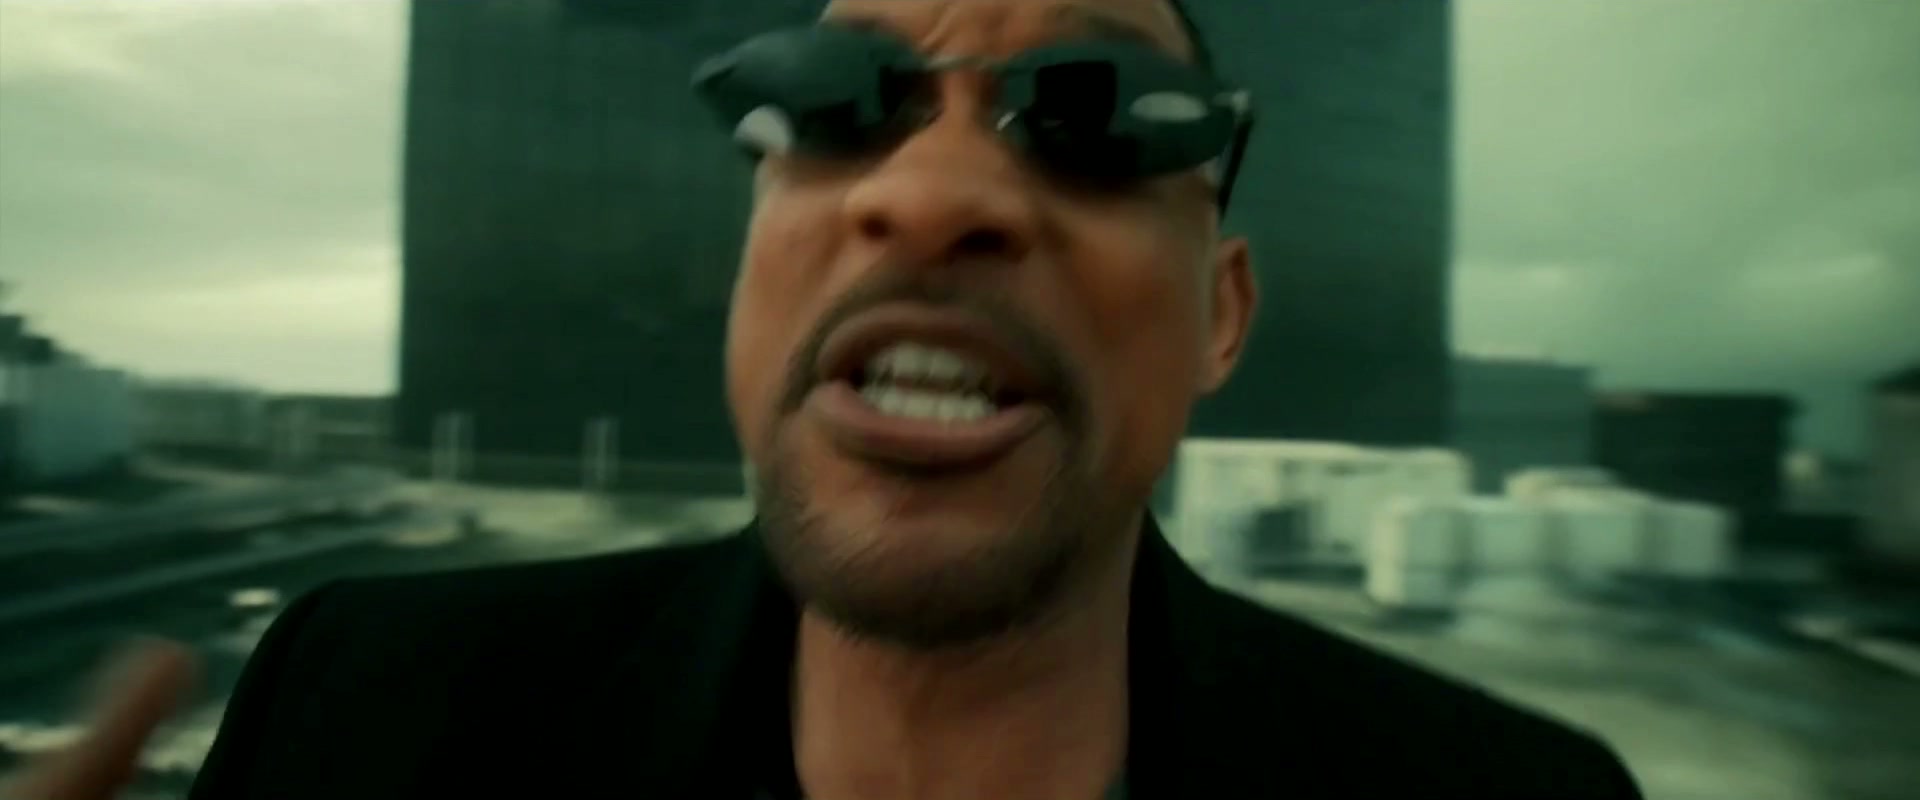 Doppiato | voce e labbra tradotte in spagnolo
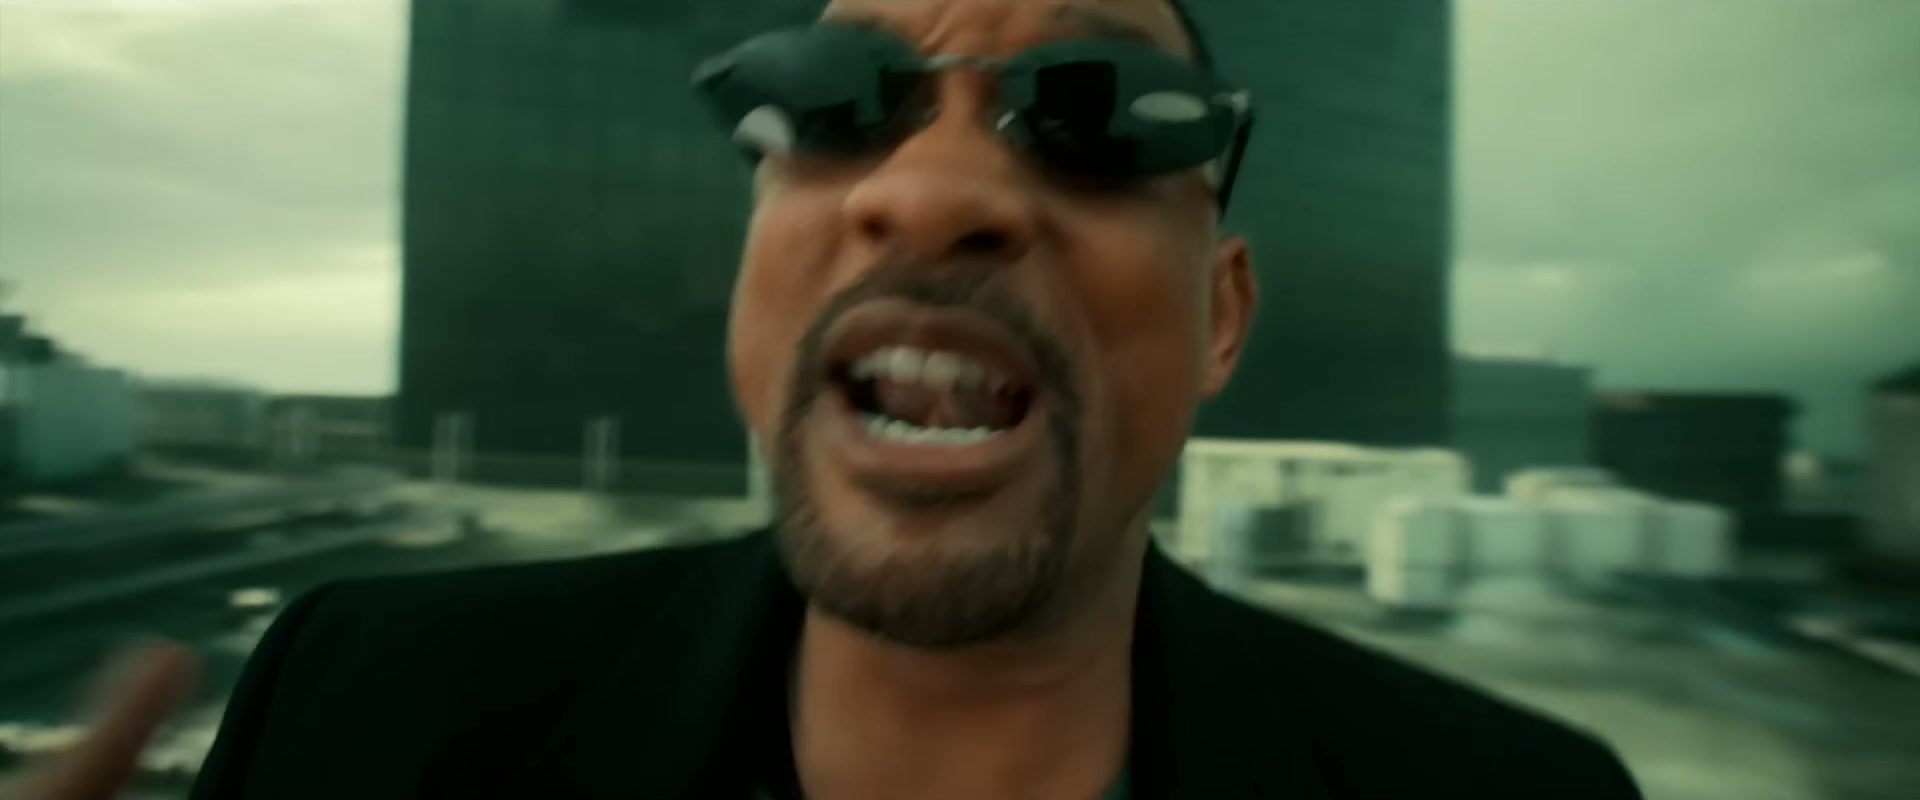 Originale | inglese, la stessa inquadratura
L'interpretazione resta così intatta che perfino le canzoni funzionano in un'altra lingua.
 Jibin SongChief ScientistTEAM →
Così si localizzano anche le canzoni, ovunque si trovino:
- Film d'animazione
- Contenuti per bambini
- Musical
- Canzoni in film e serie
- Sigle e intro
- Album e videoclip
PIÙ RICAVI, PIÙ PUBBLICO.
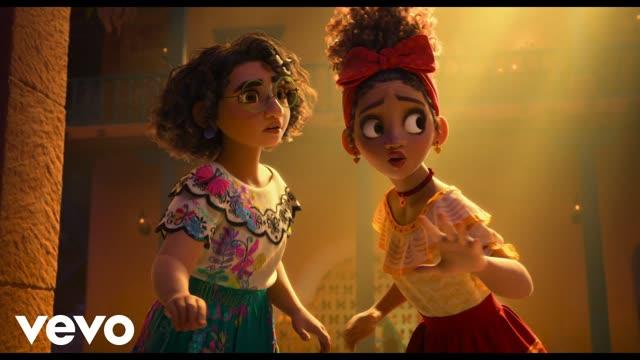 65%Non si nomina Bruno | Spagnolo (America Latina)Una sola versione doppiata ha raccolto 426 milioni di visualizzazioni, il 65% dei 656 milioni dell'originale inglese.
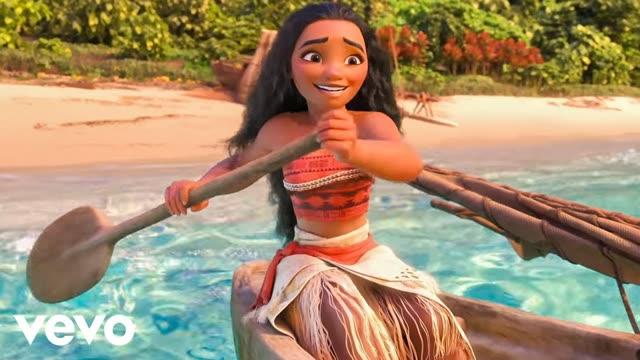 1,13 mldOltre l'orizzonte | Portoghese (Brasile)Le visualizzazioni su YouTube della versione brasiliana, contro 1,54 miliardi dell'originale inglese.
 41All'alba sorgerò | lingueL'album più venduto del 2014. In Giappone la versione locale è arrivata al n. 2 e ha superato il milione di copie certificate.
 66%Pushpa 2 | HindiLa quota del box office indiano del film incassata dal doppiaggio in hindi; l'originale in telugu ha incassato il 27%.
Ognuna è stata ricantata da un cantante locale. Con Song Dubbing a viaggiare è l'interpretazione originale.
Per le etichette discografiche: scrivi al team →23×
minuti di visione in più quando un titolo è doppiato anche nel labiale.
RISPETTO AL DOPPIAGGIO SOLO AUDIO DELLO STESSO TITOLO
IL LIMITE DEL DOPPIAGGIO UMANO
- Perdita dell'interpretazione
- Difficile da scalare
- Costoso
- L'AI attuale non è all'altezza
▚ IN UN COLPO SOLO, NON IN SETTIMANE ▞
Prima la traduzione, poi il doppiaggio in un colpo solo:
 Familiar Labs
 Flawless
 HeyGen
 ElevenLabsFamiliar LabsFlawlessHeyGenElevenLabs
Gli strumenti di supporto che l'industria usa oggi richiedono un team di artisti VFX e settimane per progetto, e ogni lingua è un progetto nuovo.
Gli strumenti che oggi fanno tutto in un colpo solo rinunciano al resto: la traduzione non si può modificare, la musica e l'ambiente spariscono, la voce si allontana da quella di chi parla, e il labiale cede con una mano davanti al volto, un microfono, una sfocatura, il bokeh, un'inquadratura di profilo o più persone in scena. Niente ragionamento spaziale, nessuna comprensione del mondo, nessun controllo.
Familiar Labs vs Flawless TrueSync →SOSTENUTI DA


 Stanford
 Yonsei

Non “AI generativa”, ma traduzione al servizio dei creativi.
Da persona a persona, non da AI ad AI →“L'AI generativa è la branca dell'intelligenza artificiale che crea contenuti originali, come testi, immagini, video, audio e codice software, in risposta ai prompt degli utenti.”

MLFM per il lavoro più noioso.
Niente prompt. Niente di nuovo generato a caso.
Da persona a persona, per arrivare più lontano.
Tutti i dati con cui abbiamo addestrato il modello li ha creati in prima persona il team di Familiar Labs.

Modello di fondazione multimodale per la localizzazione.
Un nuovo paradigma, il primo nel suo genere.
Un solo modello che decide cosa localizzare e come, tra testo, audio e video, e ti mostra le scelte che contano.

Quale traduzione per ogni battuta.
- Più traduzioni valutate; i tuoi direttori creativi vedono le opzioni con le motivazioni e scelgono.
- Cosa non tradurre: il gergo lasciato così com'è, il nome e il marchio mantenuti.
- Il riferimento sostituito con uno che il pubblico conosce, ciò che quella cultura evita, il turpiloquio attenuato per i più giovani.
Prima di tutto, cosa tradurre.
- La voce principale individuata e mantenuta: chi parla conserva la propria voce.
- Le risate, la folla, un grido, una voce che nessuno riesce a distinguere: lasciati com'erano.
- Un coro, un urlo, una frase lasciati in lingua originale.
Cosa localizzare sullo schermo.
- Chi sta davvero parlando: chi fa da narratore, chi parla fuori campo.
- Le labbra, occlusioni e ragionamento spaziale compresi.
- Le espressioni e i gesti, quando l'enfasi o la cultura lo richiedono.
- Il testo nell'inquadratura, lo schermo di un telefono, la copertina di un libro, un cartello stradale, un'insegna, con i termini che hai già scelto.
- Cosa resta così come è stato girato, deciso al volo: un sacchetto di Tostitos resta Tostitos.
- A quale volto appartiene una battuta, e quale testo tradurre.
Ogni decisione viene registrata insieme al doppiaggio. Puoi modificarla in qualsiasi momento, e una scelta fatta una volta vale anche per l'episodio successivo.
Che cos'è MLFM?▚ TESTATO SULLE STESSE CLIP ▞
Benchmark
Occlusioni e ragionamento spaziale: microfoni davanti alla bocca, mani davanti al volto, e il doppiaggio tiene.

▚ L'API ▞
La tua piattaforma, in ogni lingua.
review=manualI direttori creativi revisionano prima della pubblicazione.
- Le righe che si possono leggere in più modi, una battuta o una frecciata, tornano in tre traduzioni, ognuna con intenzione ed emozione diverse.
- I tuoi direttori creativi ne scelgono una.
- Modificano qualsiasi riga confrontandola con l'originale e avviano il doppiaggio.
- 1Apples. I'm sorry, right down to the core.Gioco di parole · timido
- 2I came to say sorry. I brought apples.Solo il senso · sincero
- 3An apple a day keeps the silent treatment away.Nuova battuta · giocoso
- 1Wow. You're incredible.Sincero · caloroso
- 2Well, aren't you something.Sarcastico · asciutto
- 3Look at you, hotshot.Canzonatorio · giocoso
/v1/dubs/dub_31xk9m/render- TRADUZIONE00:12.4seg_12 · 사과하려고 사과 사 왔어.Apples. I'm sorry, right down to the core.I came to say sorry. I brought apples.An apple a day keeps the silent treatment away.Scelta del direttore creativoEDITED
- AUDIO00:41.2 – 00:44.0Crowd chantKeep in KoreanTranslateModifica
- VIDEO00:58.0Phone screen · 내일 봐See you tomorrowKeep as shotModifica
- VIDEO01:12.6SpeakerSpeaker 1Speaker 2Speaker 3Modifica
/v1/dubs/dub_31xk9m/decisions/GET /v1/dubs/{dub_id}/decisionsTutte le decisioni, nero su bianco: leggile e modificale.
Già oggi i tuoi direttori creativi vedono le traduzioni possibili con le motivazioni. Le decisioni su audio e video sono in lavorazione: un coro lasciato in lingua originale, a quale volto appartiene una battuta, il testo sullo schermo di un telefono.
Esplora la documentazione →Inferenza privata: GPU di nostra proprietà a Toronto, mai un cloud pubblico.
Ogni doppiaggio viene elaborato sul nostro cluster a otto cifre di GPU NVIDIA B300, le migliori sul mercato, a Toronto, in Canada. I tuoi video non vengono mai elaborati su un cloud pubblico come Google Cloud o AWS, né da fornitori di inferenza esterni: per questo non trapelano mai.
Esplora la documentazione →- GPUS
- NVIDIA B300, the best on the market
- CLUSTER
- Eight figures, USD
- LOCATION
- Toronto, Canada
- OPERATOR
- Familiar Labs, on compute we own
- PUBLIC CLOUD
- None
- THIRD-PARTY INFERENCE
- None
Solo per le aziende: un contratto Studio con prezzi in base ai volumi e supporto dedicato 24/7.
▚ LINGUE ▞
13 lingue, da qualsiasi a qualsiasi.
Raggiungi ogni pubblico con la propria voce e le proprie labbra.
IN ENTRATA E IN USCITA13
- arabo
- cinese
- coreano
- francese (Francia)
- giapponese
- hindi
- inglese
- italiano
- portoghese (Brasile)
- russo
- spagnolo (America Latina)
- tedesco
- thailandese
▚ SICUREZZA ▞
Sigillati sul tuo computer. Aperti solo a Toronto.
I tuoi contenuti non vengono mai usati per l'addestramento.
CARICAMENTO SIGILLATO
Crittografati sul tuo computer, prima di uscire dalla tua rete: un file intercettato in transito è illeggibile. Il doppiaggio finito torna sigillato allo stesso modo.
I NOSTRI SERVER A TORONTO
Elaborati e archiviati sulla nostra potenza di calcolo a Toronto, in Canada; nessun cloud pubblico, nessun fornitore di inferenza esterno.
PRIVILEGIO MINIMO
Le chiavi di decrittografia sono custodite da due dirigenti designati; nessuno al di fuori dei nostri ruoli di sicurezza designati può aprire i tuoi contenuti.
ELIMINATI A SCADENZA
Eliminati nel momento in cui ti restituiamo il doppiaggio (nessuna conservazione dei dati), alla tua approvazione, o in automatico 14 giorni dopo la consegna.
MEMBRO TPN+ | MPA CONTENT SECURITY BEST PRACTICES
Per i lavori di studi, piattaforme di streaming ed etichette discografiche sotto contratto.

Domande?
Un doppiaggio di nuova generazione: la tua voce e le tue labbra, portate in nuove lingue; anche mettendo insieme ElevenLabs e HeyGen, voce e volto restano quelli di un estraneo. Ed è più di una sincronizzazione labiale con l'AI: tutto il volto recita nella nuova lingua, occlusioni e ragionamento spaziale compresi.
Nel nostro benchmark pubblicato:
- il suo prodotto più recente ha il 270% in più di errori sui suoni di sottofondo: le risate, la musica, l'atmosfera
- il 54,7% in meno di errori importanti di traduzione rispetto al suo prodotto più recente
- sul suo Dubbing v1 la nostra voce è risultata il 27,8% più simile alla voce reale di chi parla, più vicina in tutte e 11 le lingue
Sulle stesse clip, ElevenLabs:
- ha omesso o inventato parole 45 volte
- ha rovinato risate ed effetti sonori 8 volte
- ha perso la voce di chi parla 6 volte
- ha confuso le voci sovrapposte 6 volte
- ha appiattito l'interpretazione 4 volte
- ha cancellato i suoni d'ambiente della scena 4 volte
- la sua API rifiuta le clip sotto gli 11 secondi
Mettere insieme i pezzi costa $11 al minuto: $8 per il lip sync di Sync.so più $3 per l'audio di ElevenLabs. Un doppiaggio Familiar Labs include voce, lip sync e traduzione, fino al 4K, con mix surround 5.1 nativo o stereo.