TEAM
Dottori di ricerca e ricercatori
 Stanford
 Yonsei

Esistiamo per abbattere ogni barriera alla comprensione.
Immagina un mondo in cui tutto ciò che guardiamo e ascoltiamo passa in ogni lingua, senza che si noti. Le canzoni amate dai nostri genitori e dalle nostre famiglie, finalmente comprensibili anche per noi; le nostre canzoni inglesi preferite in coreano e in cinese, così anche loro le capiscono e le ascoltano. Chi parla inglese si gode il meglio della Corea, della Cina e di tutto il resto del mondo. Tutti gli altri guardano i contenuti in inglese senza sottotitoli.
Voglio mettere queste canzoni tradotte nella mia playlist.
 Andrew LiuCEODa persona a persona, non da AI ad AI →
In tanti, nel team, abbiamo imparato l'inglese guardando la televisione. Il nostro CEO, Andrew Liu, non riusciva a parlare in inglese con i compagni, non aveva amici ed era l'unico asiatico di tutta la scuola; la lingua l'ha imparata guardando la TV, e non l'ha mai dimenticato.
Per questo esiste Familiar Labs: perché ciò che passa su uno schermo arrivi a tutti, nella lingua che capiscono.




▚ HALLOWEEN 2026 ▞
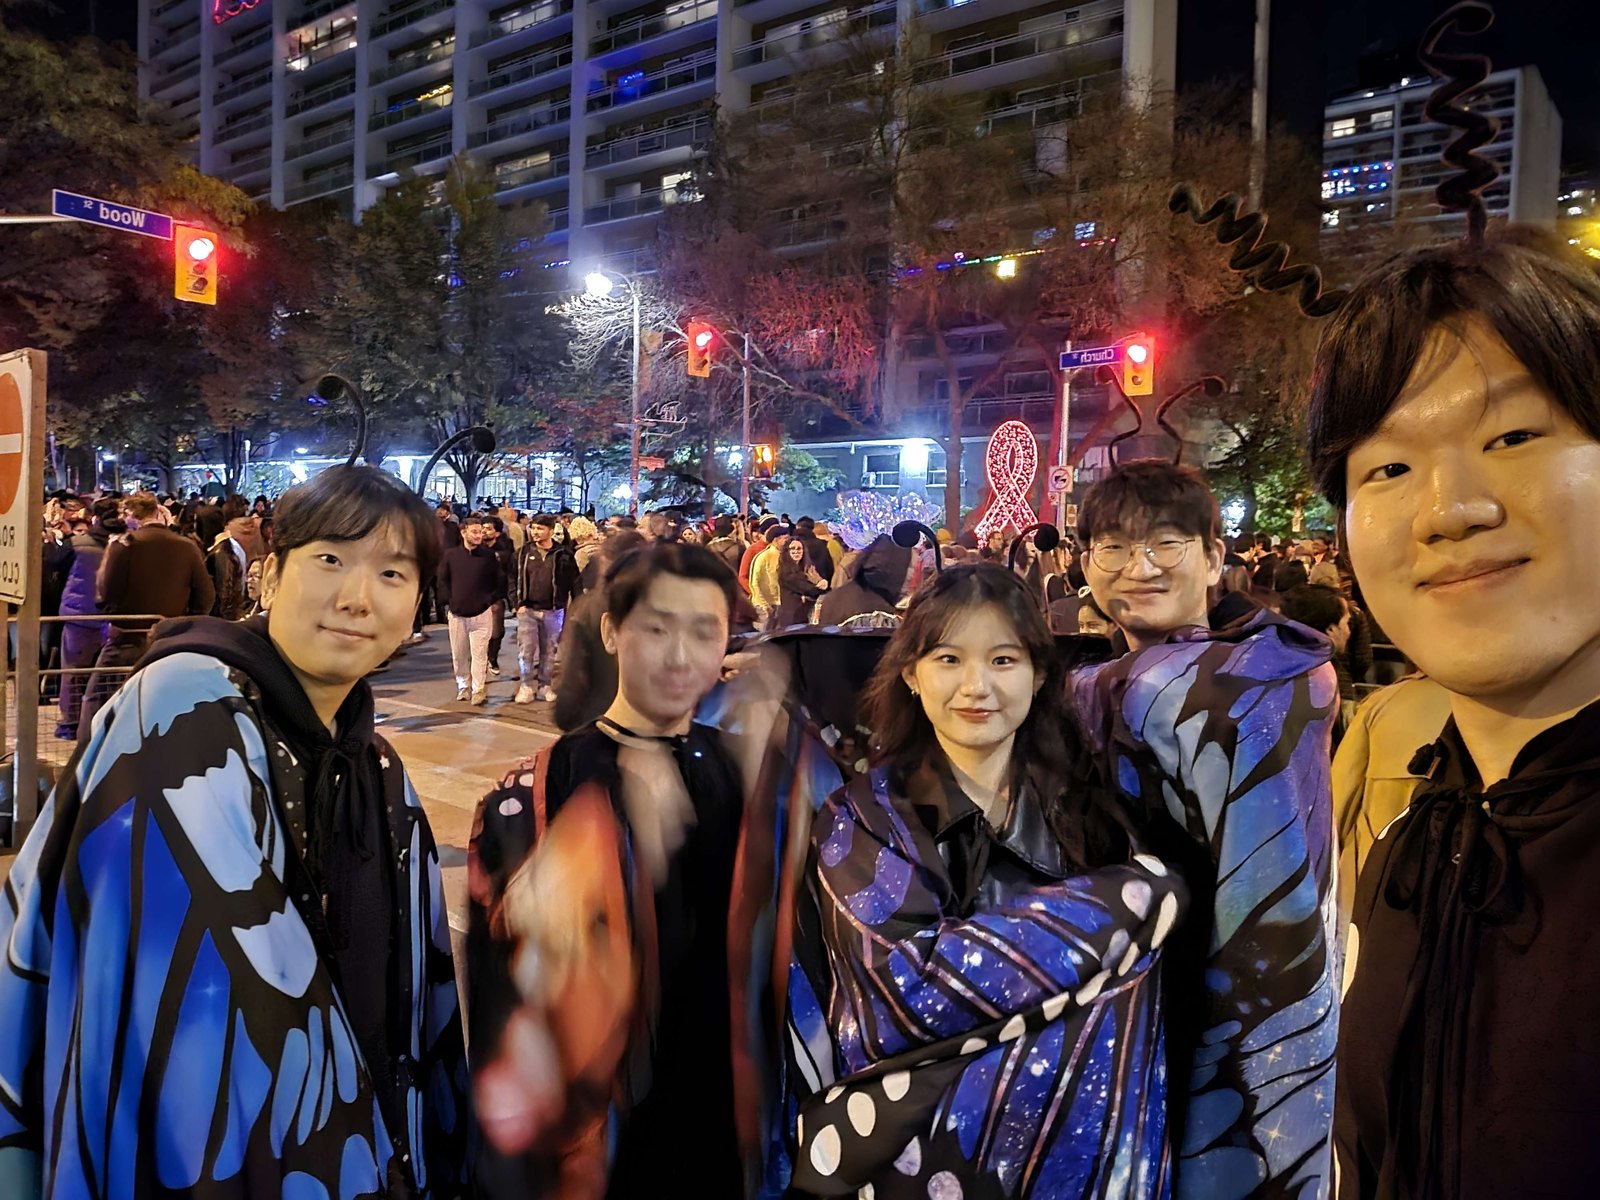
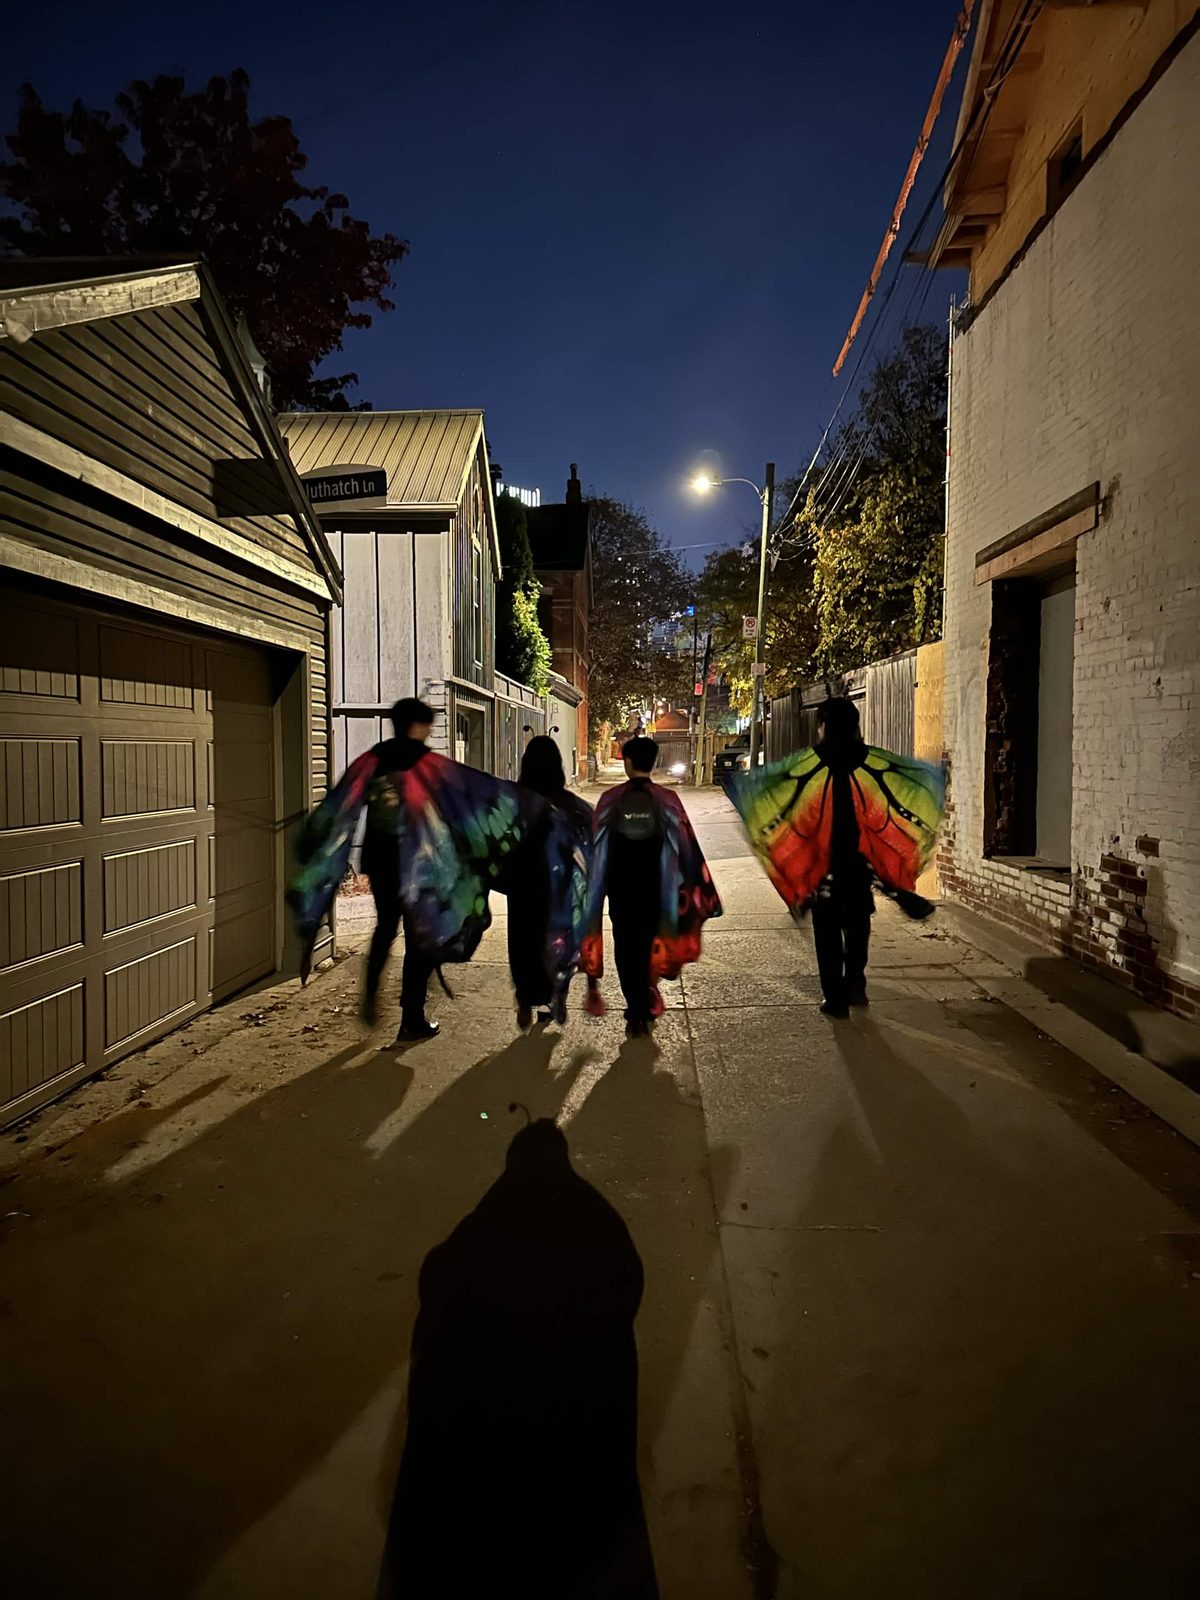
Toronto, la notte di Halloween: il team si è travestito da farfalle.
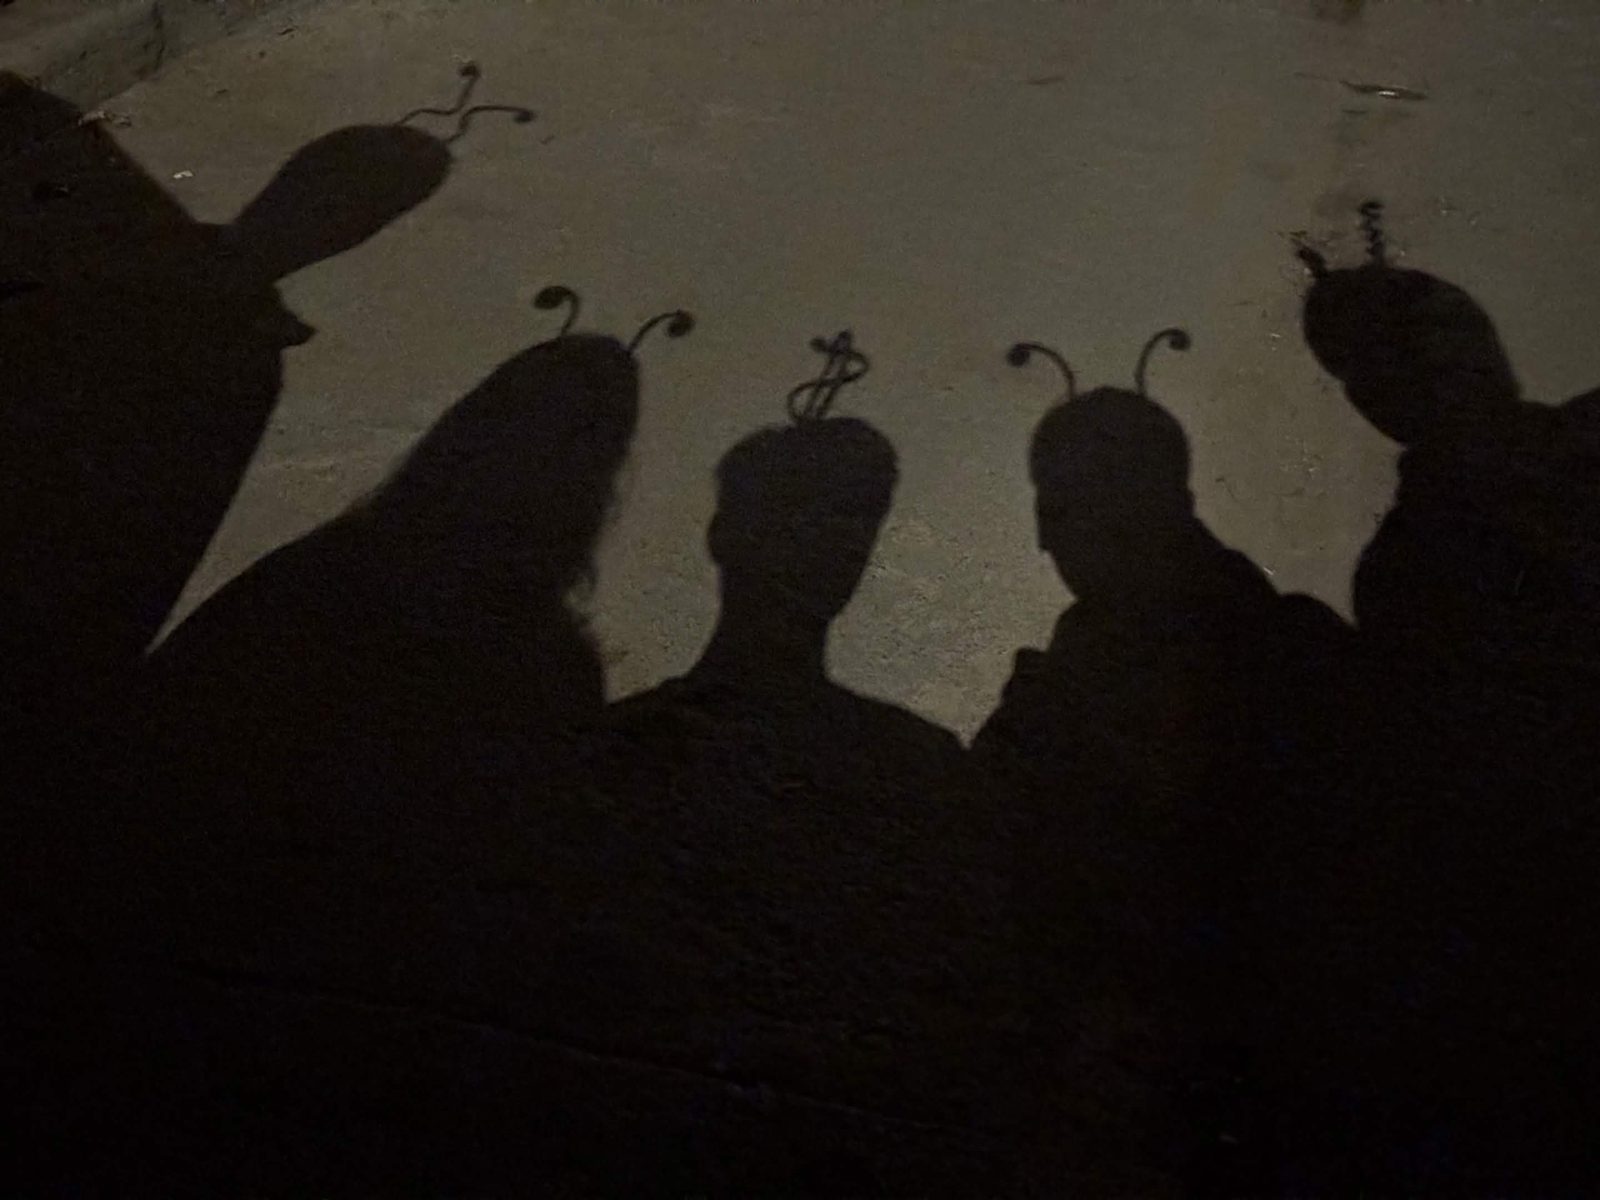
▚ RICERCA ▞
Voce e volto da un unico modello, così l'identità non può mai sdoppiarsi: il campo che abbiamo fondato con JAM-Flow.
Gli esseri umani in tempo reale oggi più fedeli al vero: SoulX-LiveAct anima una persona a 20 fotogrammi al secondo, stabile per un'ora.
Distillazione, guidance e campionamento: la ricerca che rende i modelli di diffusione abbastanza veloci per il tempo reale.
Editing dentro i modelli di diffusione congelati, dalla scoperta dell'h-space al controllo dello stile e alla rimozione del testo in sovrimpressione.
Leggere la scena prima di modificarla: chi sta parlando, incrociando immagine e audio, in qualsiasi ambiente.


▚ TESTATO SULLE STESSE CLIP ▞


SOSTENUTI DA


- Stanford
- Yonsei