팀
박사와 연구자
 Stanford
 Yonsei

우리는 이해를 가로막는 모든 장벽을 없애기 위해 존재합니다.
우리가 보고 듣는 모든 것이 어떤 언어로든 이질감 없이 재생되는 세상을 상상해 보세요. 부모님과 가족이 즐겨 듣는 노래를 드디어 우리도 알아듣고, 우리가 좋아하는 영어 노래는 한국어와 중국어로 전해져 그분들도 이해하며 함께 듣습니다. 영어권 시청자는 한국과 중국, 그리고 세계 곳곳의 가장 좋은 콘텐츠를 만납니다. 그 밖의 모든 시청자는 영어 콘텐츠를 자막 없이 봅니다.
번역된 이 노래들, 제 플레이리스트에 넣고 싶어요.
 Andrew LiuCEO사람에서 사람으로, AI에서 AI로가 아니라 →
저희 팀에는 TV로 영어를 배운 사람이 많습니다. 저희 CEO Andrew Liu는 반 친구들에게 영어 한마디 건넬 수 없었고, 친구도 없었으며, 학교 전체에서 유일한 아시아인이었습니다. 영어는 TV를 보며 배웠고, 그 시절은 한 번도 그를 떠난 적이 없습니다.
Familiar Labs가 존재하는 이유입니다: 화면에 나오는 것이 모두에게, 각자 이해하는 언어로 닿도록.




▚ 할로윈 2026 ▞
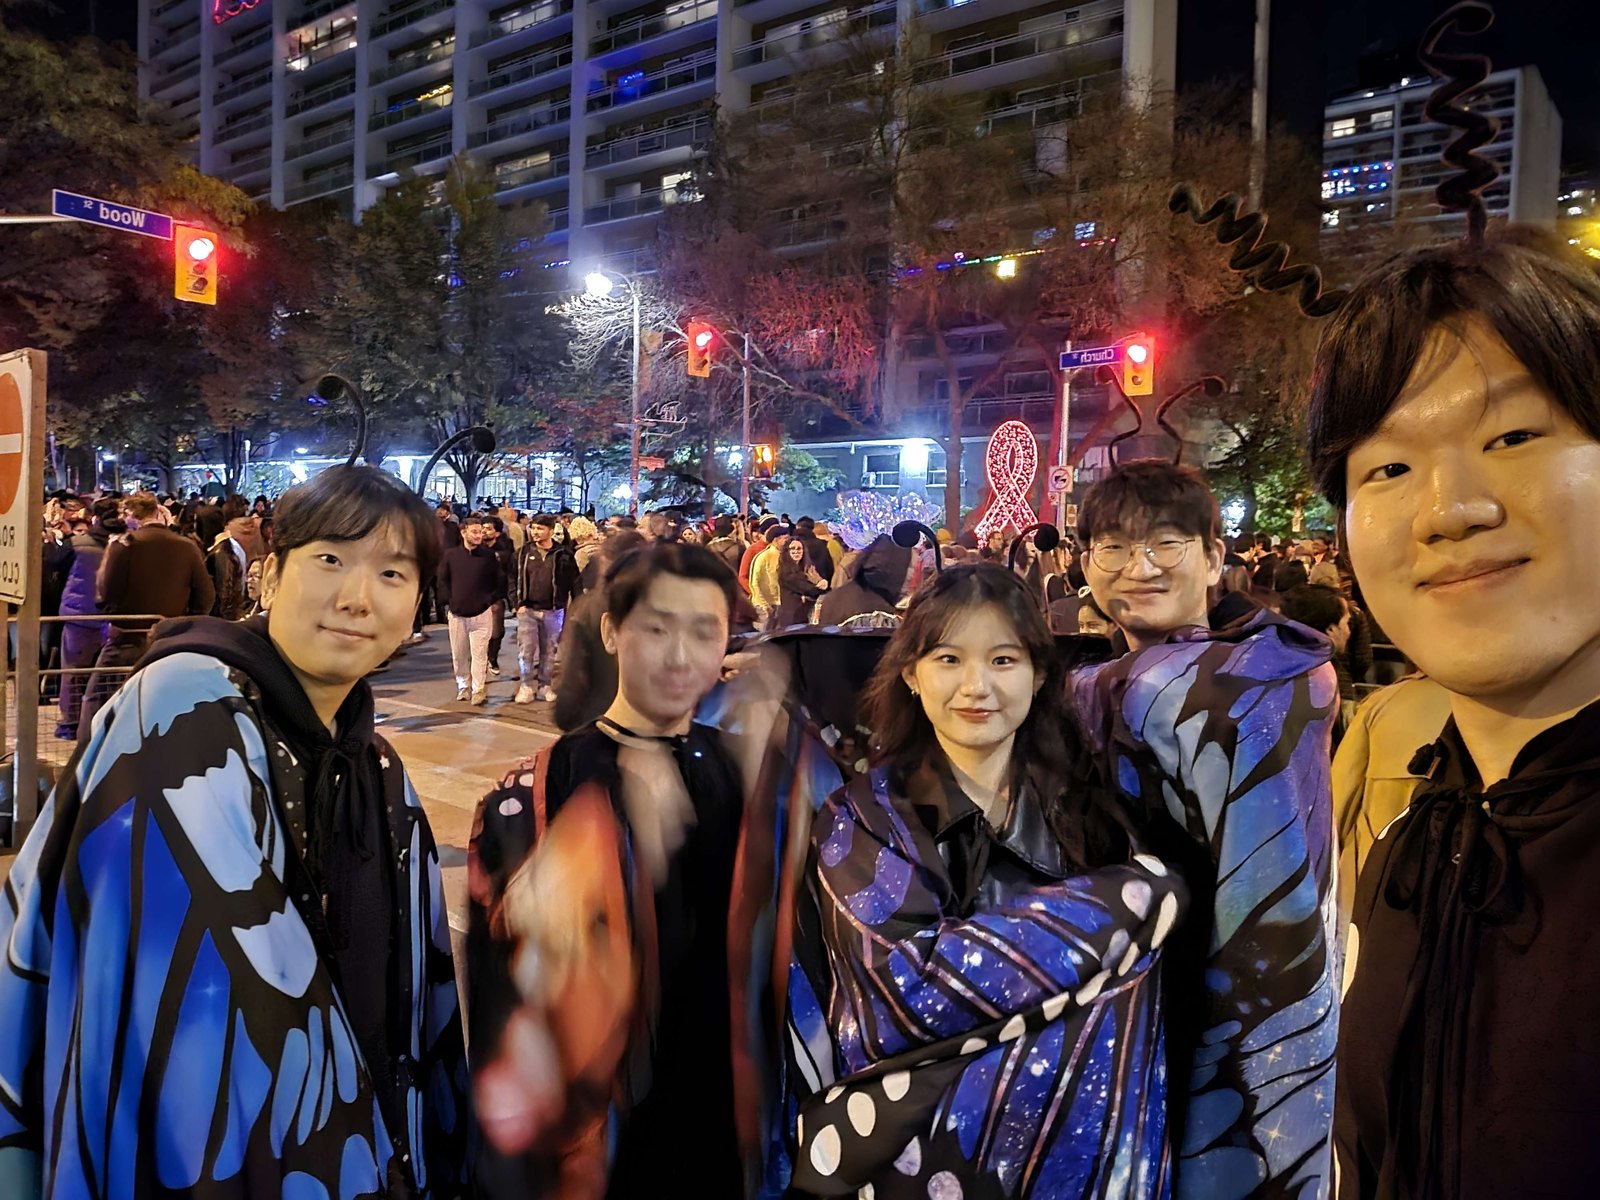
할로윈 밤의 토론토, 팀 모두 나비로 분장했습니다.
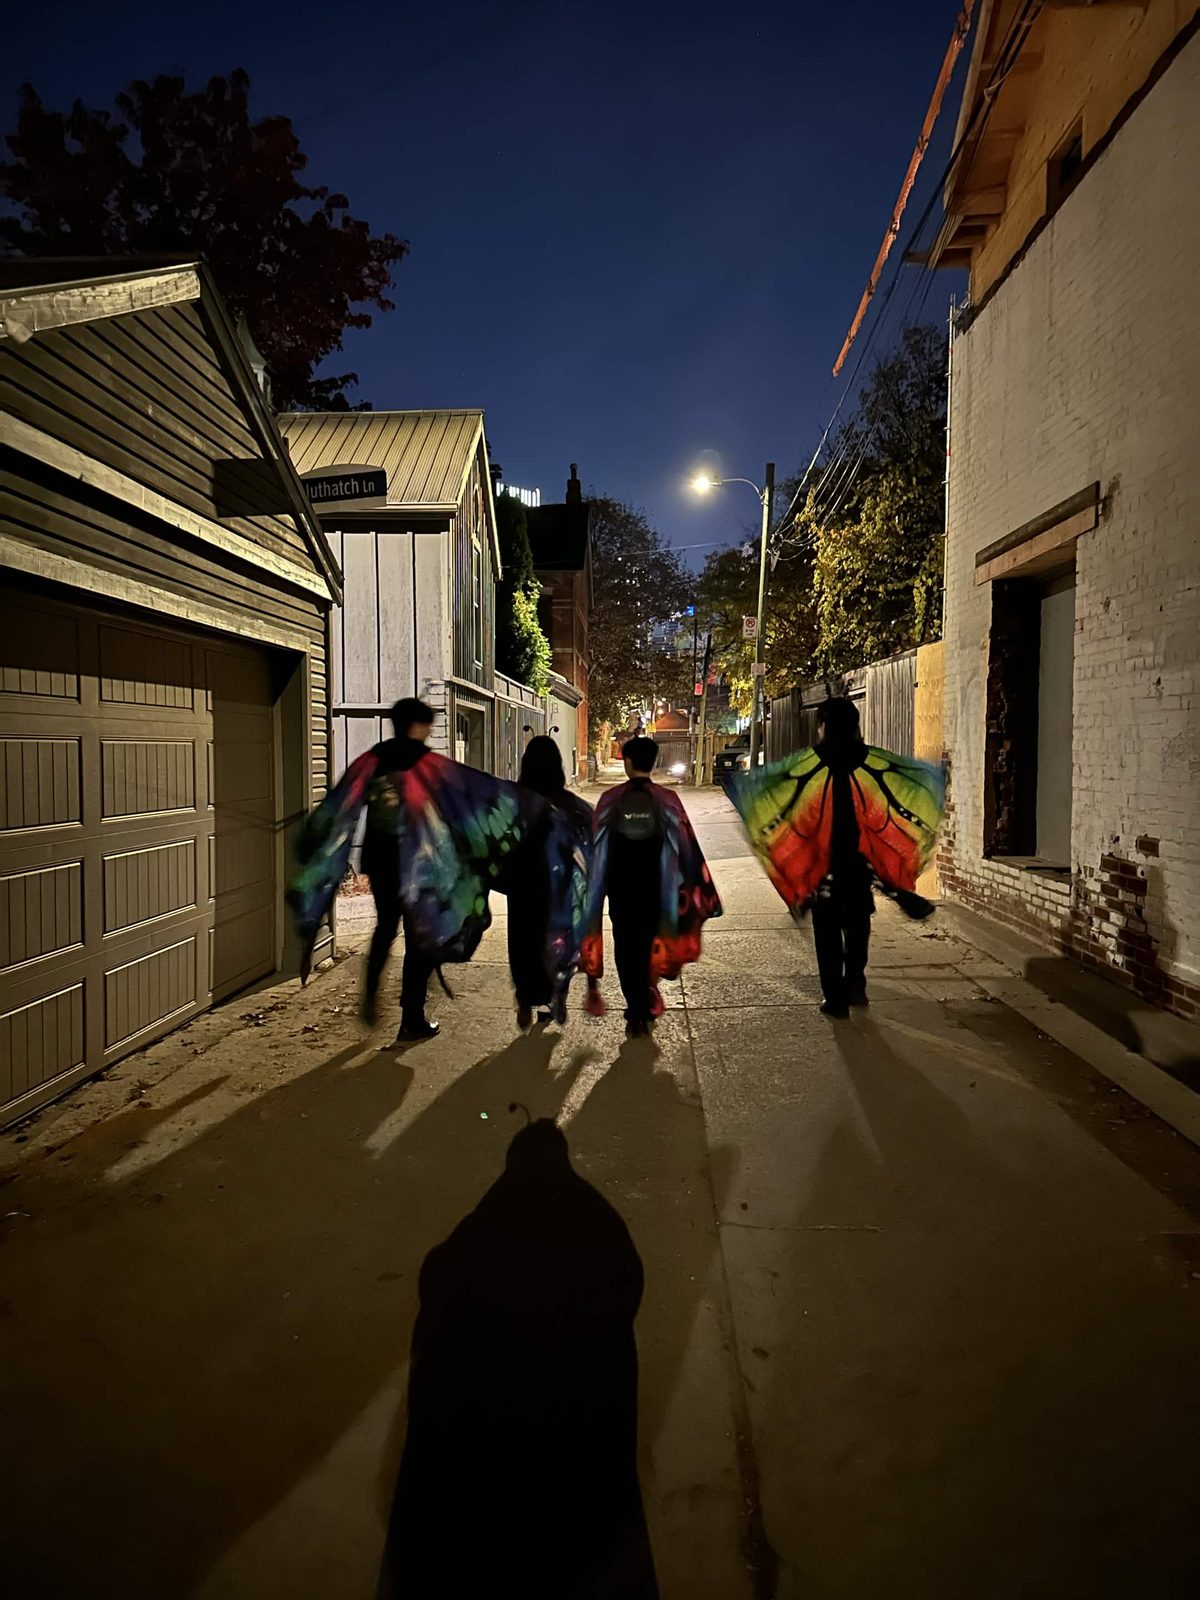
▚ 연구 ▞
목소리와 얼굴이 하나의 모델에서 나오기 때문에, 정체성이 둘로 갈라질 수 없습니다. JAM-Flow로 저희가 개척한 분야입니다.
오늘날 가장 사실적인 실시간 인물 영상 생성: SoulX-LiveAct는 초당 20프레임으로 인물을 구현하고, 한 시간 동안 안정적으로 이어 갑니다.
증류, 가이던스, 샘플링: 디퓨전 모델을 실시간에 쓸 수 있을 만큼 빠르게 만드는 연구입니다.
고정된 디퓨전 모델 안에서의 편집: h-space의 발견부터 스타일 제어, 화면 위 텍스트 제거까지.
편집하기 전에 장면부터 읽습니다. 어떤 환경에서든, 영상과 소리를 함께 보고 누가 말하는지 알아냅니다.


▚ 동일 클립으로 테스트 ▞


투자사


- Stanford
- Yonsei