КОМАНДА
PhD и исследователи
 Stanford
 Yonsei

Мы существуем, чтобы сломать любой барьер на пути к взаимопониманию.
Представь мир, где всё, что мы смотрим и слушаем, идёт на любом языке, и швов не видно. Мы наконец понимаем песни, которые любят наши родители и близкие, а наши любимые английские песни звучат по-корейски и по-китайски, чтобы и они их понимали и слушали. Англоязычные зрители получают лучшее из Кореи, Китая и всего остального мира. Все остальные смотрят английский контент без субтитров.
Хочу добавить эти переведённые песни к себе в плейлист.
 Andrew LiuCEOОт человека к человеку, а не от ИИ к ИИ →
Многие из нас в команде выучили английский по телевизору. Наш CEO, Andrew Liu, не мог заговорить с одноклассниками по-английски, друзей у него не было, и он был единственным азиатом во всей школе; язык он выучил по телевизору, и это осталось с ним навсегда.
Поэтому и существует Familiar Labs: чтобы то, что идёт на экране, доходило до каждого на понятном ему языке.




▚ ХЭЛЛОУИН 2026 ▞
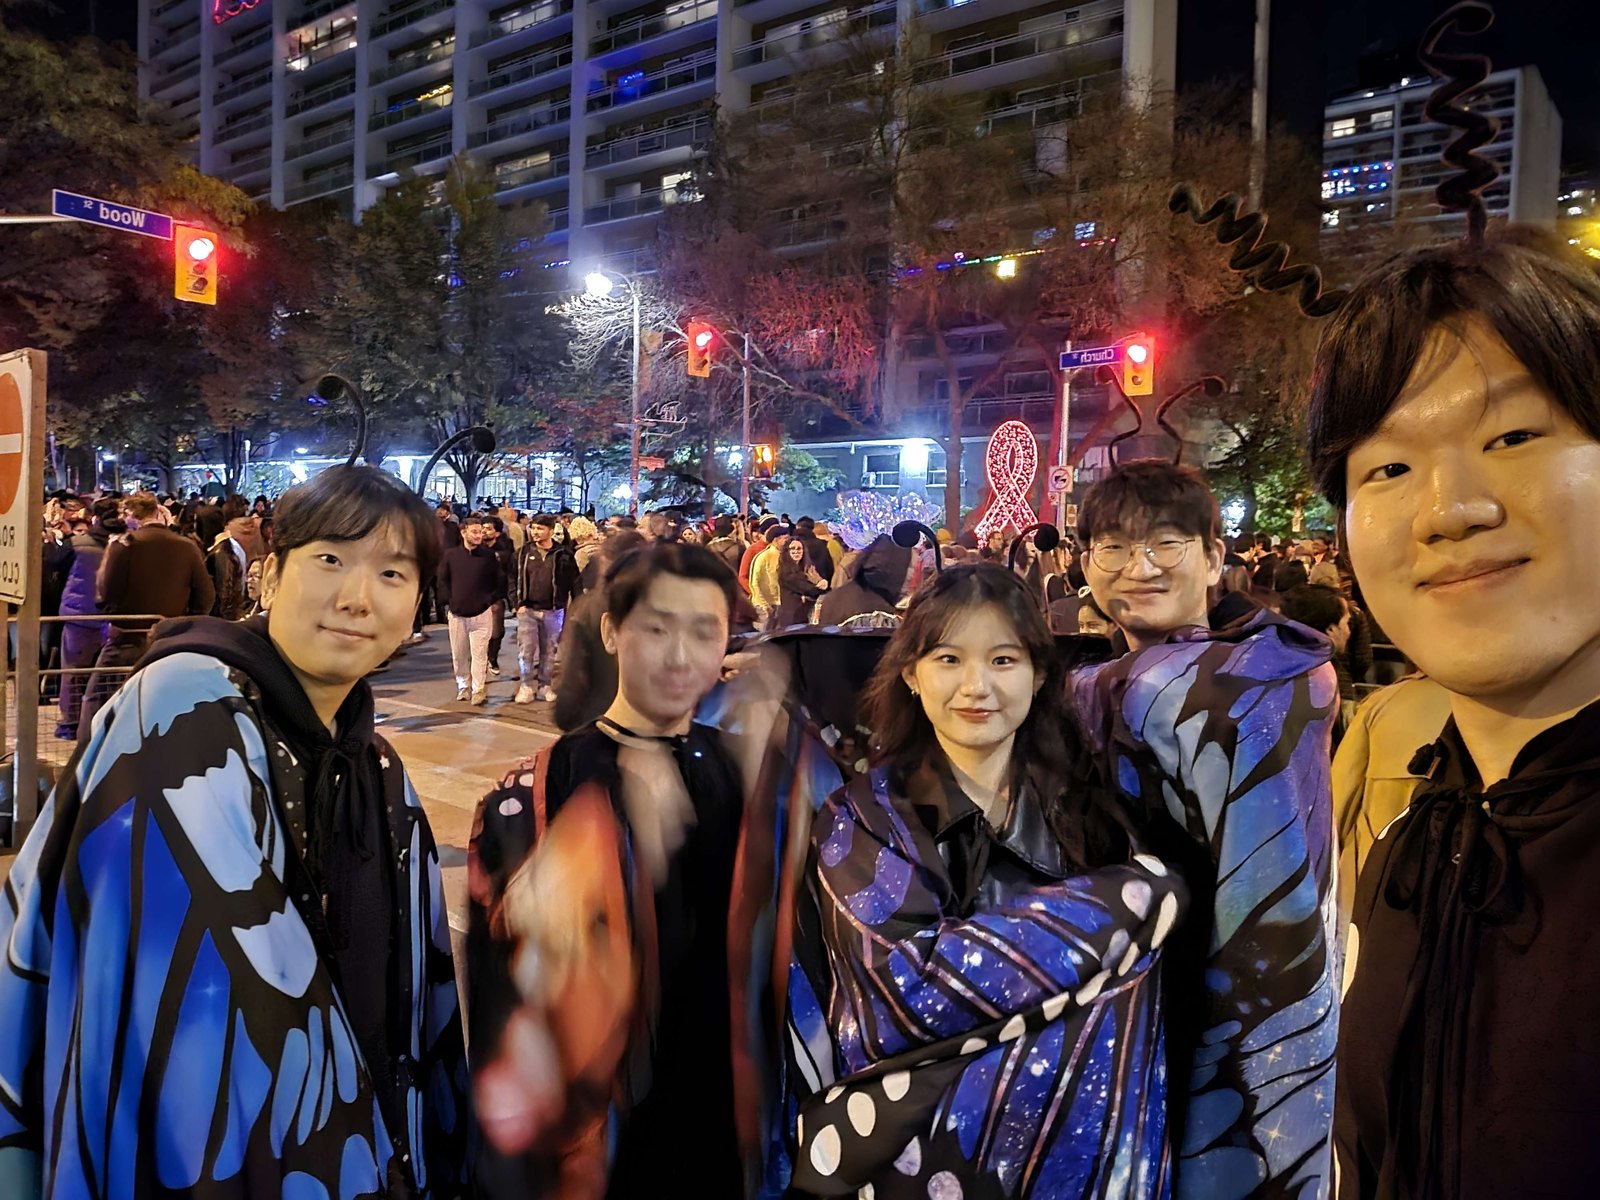
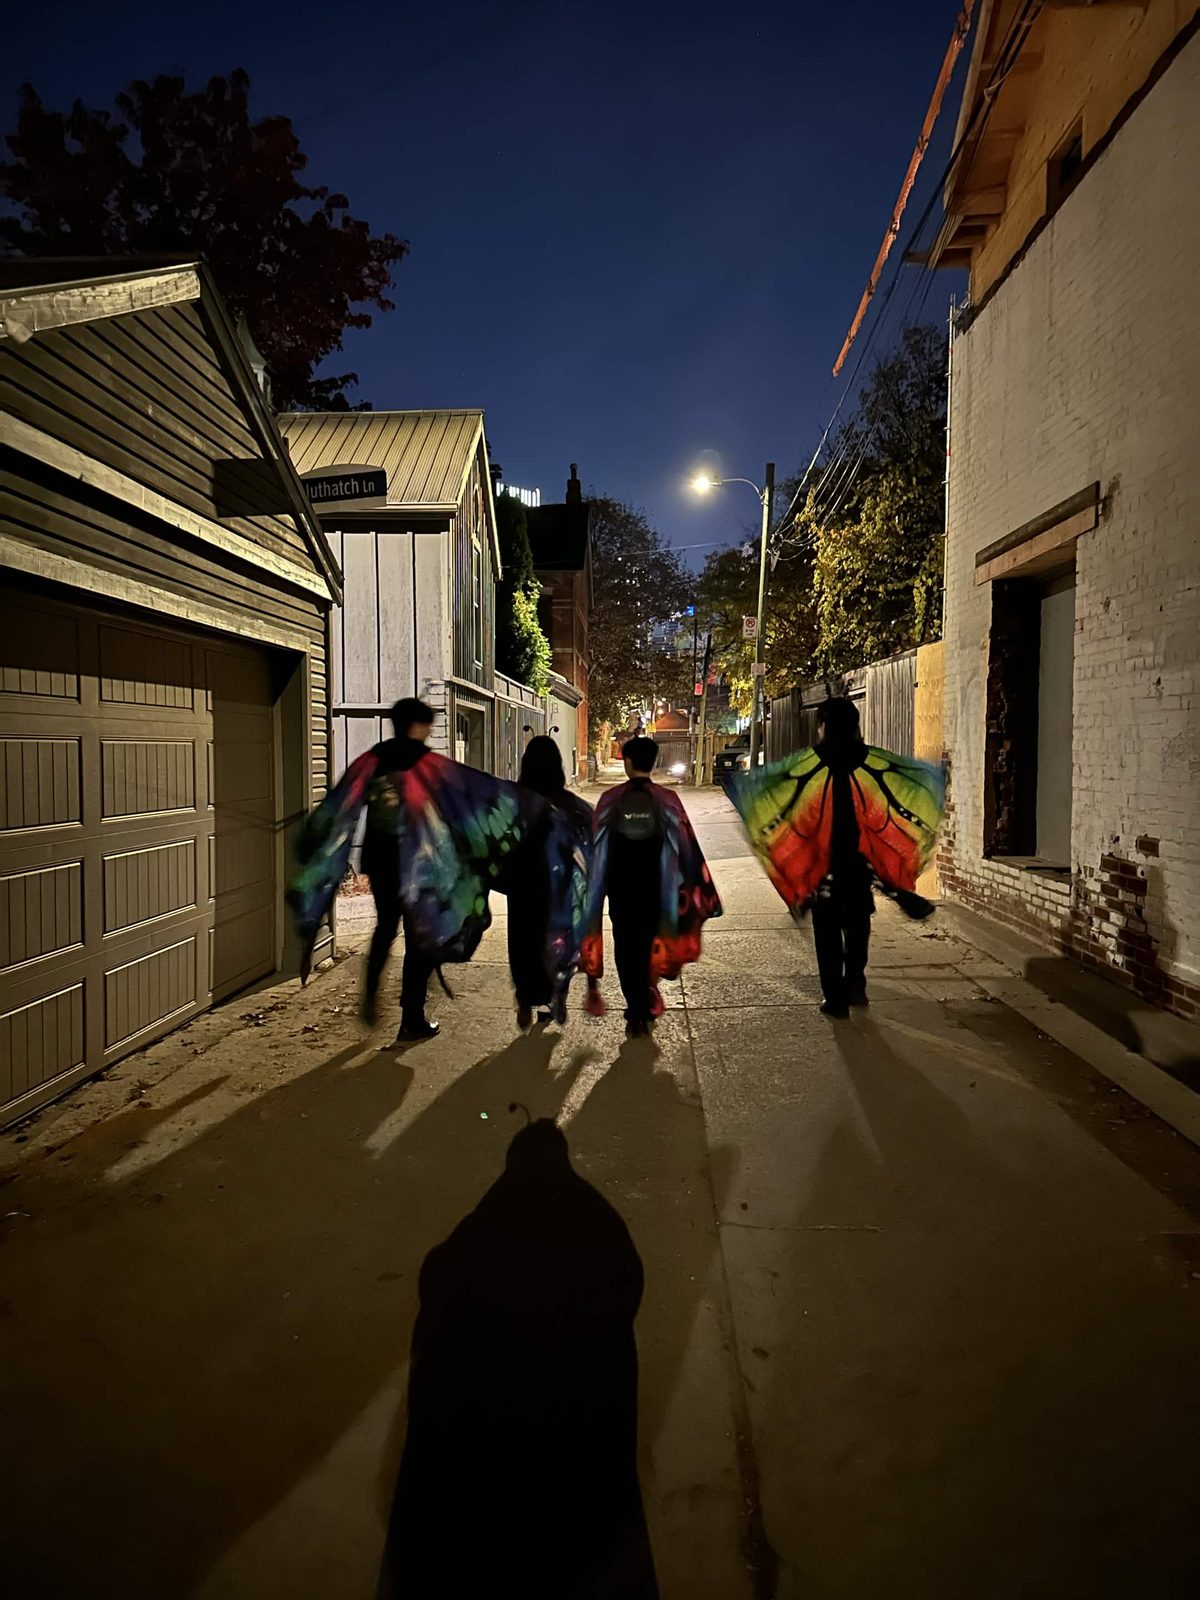
Ночь Хэллоуина в Торонто: вся команда нарядилась бабочками.
▚ ИССЛЕДОВАНИЯ ▞
Голос и лицо из одной модели, и они в принципе не могут разойтись: этому направлению мы положили начало работой JAM-Flow.
Самые реалистичные люди в реальном времени на сегодня: SoulX-LiveAct анимирует человека с частотой 20 кадров в секунду, стабильно в течение часа.
Дистилляция, guidance и сэмплирование: исследования, которые делают диффузионные модели достаточно быстрыми для работы в реальном времени.
Редактирование внутри замороженных диффузионных моделей: от открытия h-space до управления стилем и удаления текста из кадра.
Сначала прочитать сцену, потом править: кто сейчас говорит, по картинке и звуку вместе, в любой обстановке.


▚ ТЕСТ НА ОДНИХ И ТЕХ ЖЕ РОЛИКАХ ▞


ПРИ ПОДДЕРЖКЕ


- Stanford
- Yonsei