チーム
博士・研究者
 Stanford
 Yonsei

理解を阻むあらゆる壁を壊すために、私たちは存在します。
私たちが観るもの、聴くものが、どれもすべての言語で違和感なく流れる世界を想像してみてください。親や家族が愛する歌が、ようやく私たちにも分かる。私たちの好きな英語の歌も、韓国語や中国語になって家族に届き、意味が分かるから一緒に聴いてもらえる。英語を話す人には、韓国や中国をはじめ世界中の最高の作品が届く。それ以外の人には、英語のコンテンツが字幕なしで届く。
この翻訳版の曲、プレイリストに入れたいな。
 Andrew LiuCEO人から人へ、AIからAIへではなく →
Andrew LiuCEOアクセス承認者
私たちのチームの多くは、テレビで英語を覚えました。CEOのAndrew Liuは、クラスメートと英語で話せず、友だちもいませんでした。学校全体で、アジア人は彼ひとりだけ。テレビを観て言葉を覚え、その経験は今も彼の中に残っています。
だからFamiliar Labsは存在します。画面に映るものが、誰にでも、その人がわかる言語で届くように。

Jibin Songチーフサイエンティスト第二鍵管理者 | 変更承認者


Michael ChanCBOインシデント対応責任者
Taehwan Leeテクニカルスタッフ
Tonghyun Leeテクニカルスタッフ


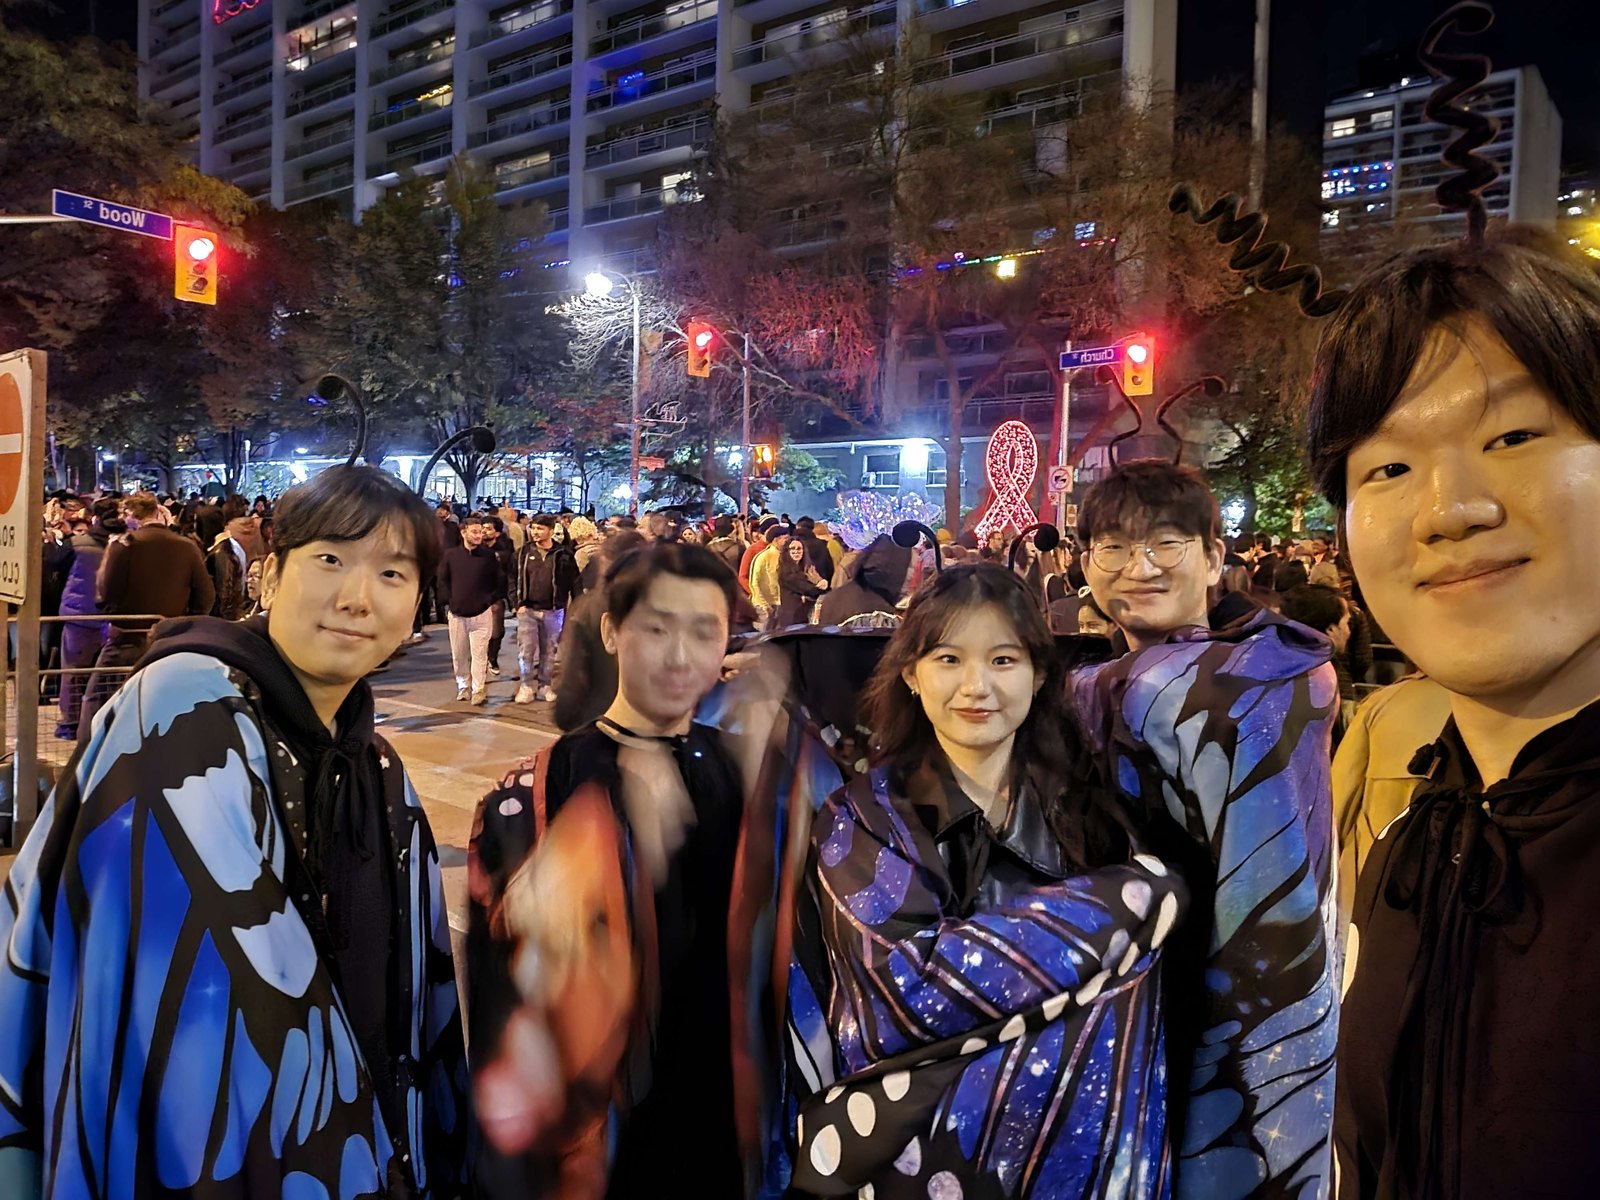
▚ ハロウィン 2026 ▞
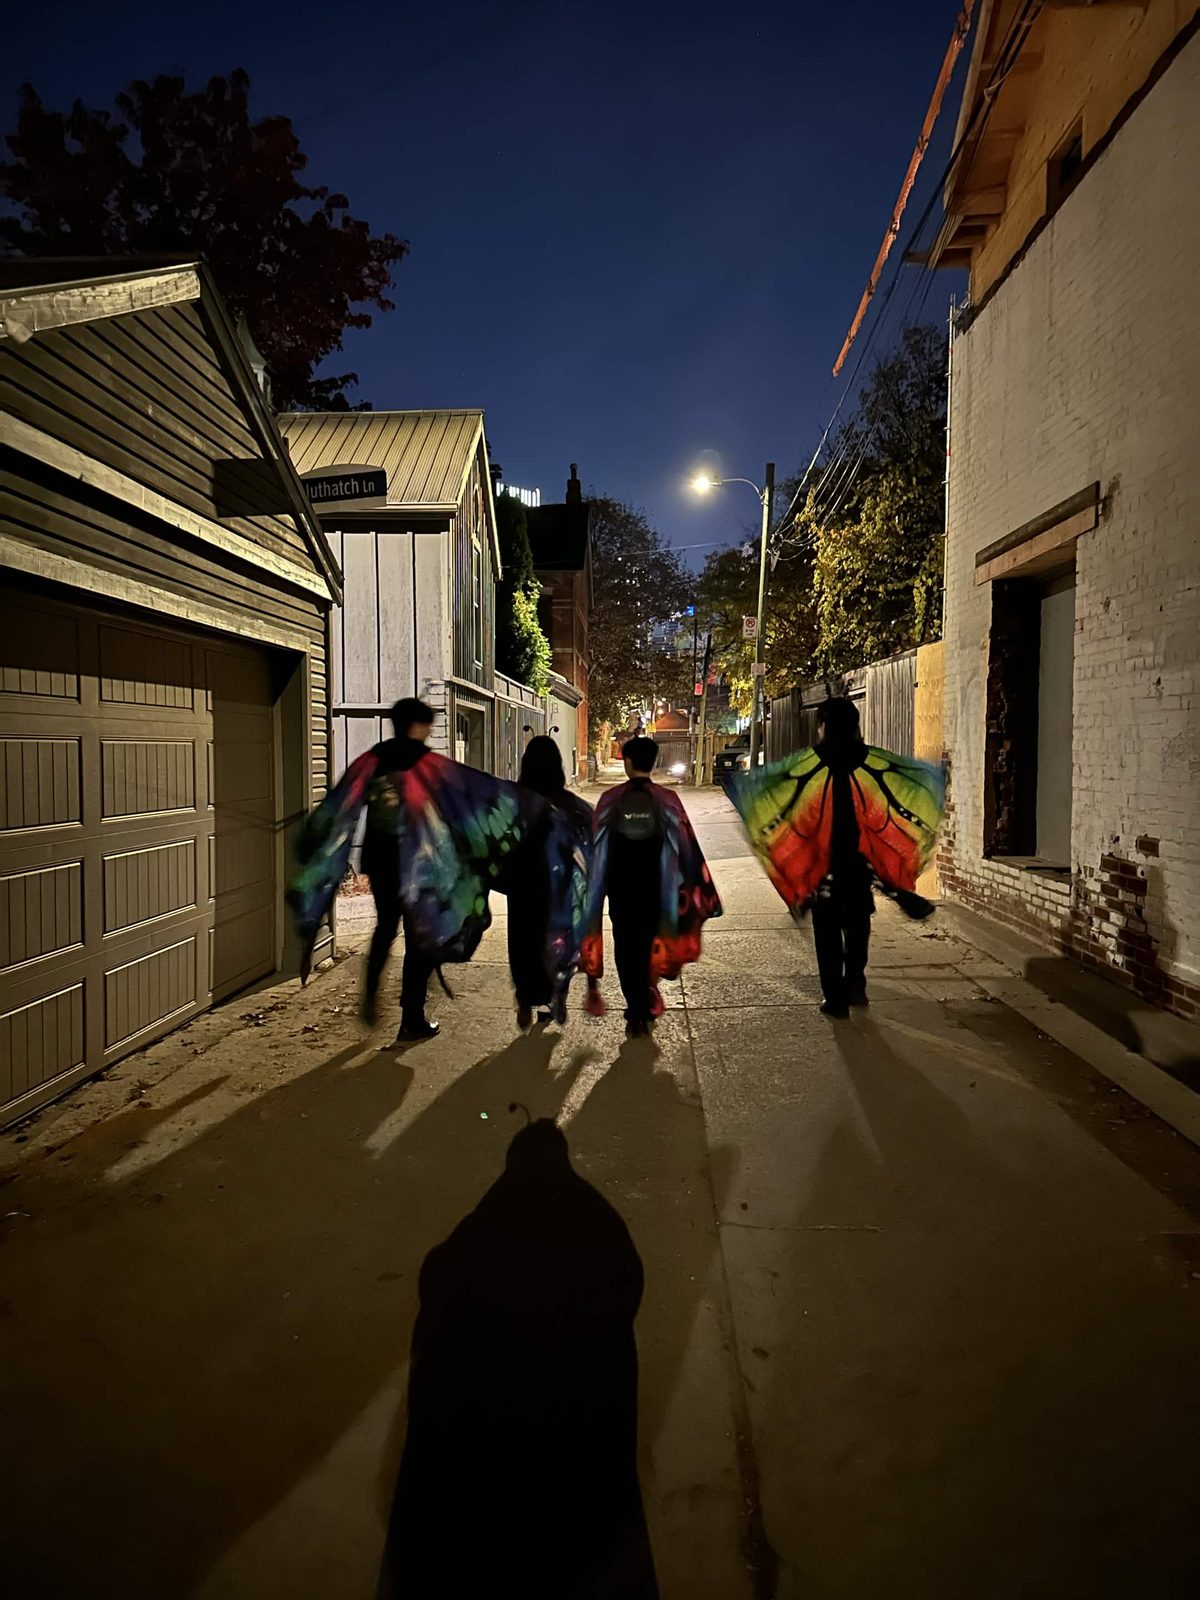
ハロウィンの夜、トロント。チーム全員で蝶に仮装しました。
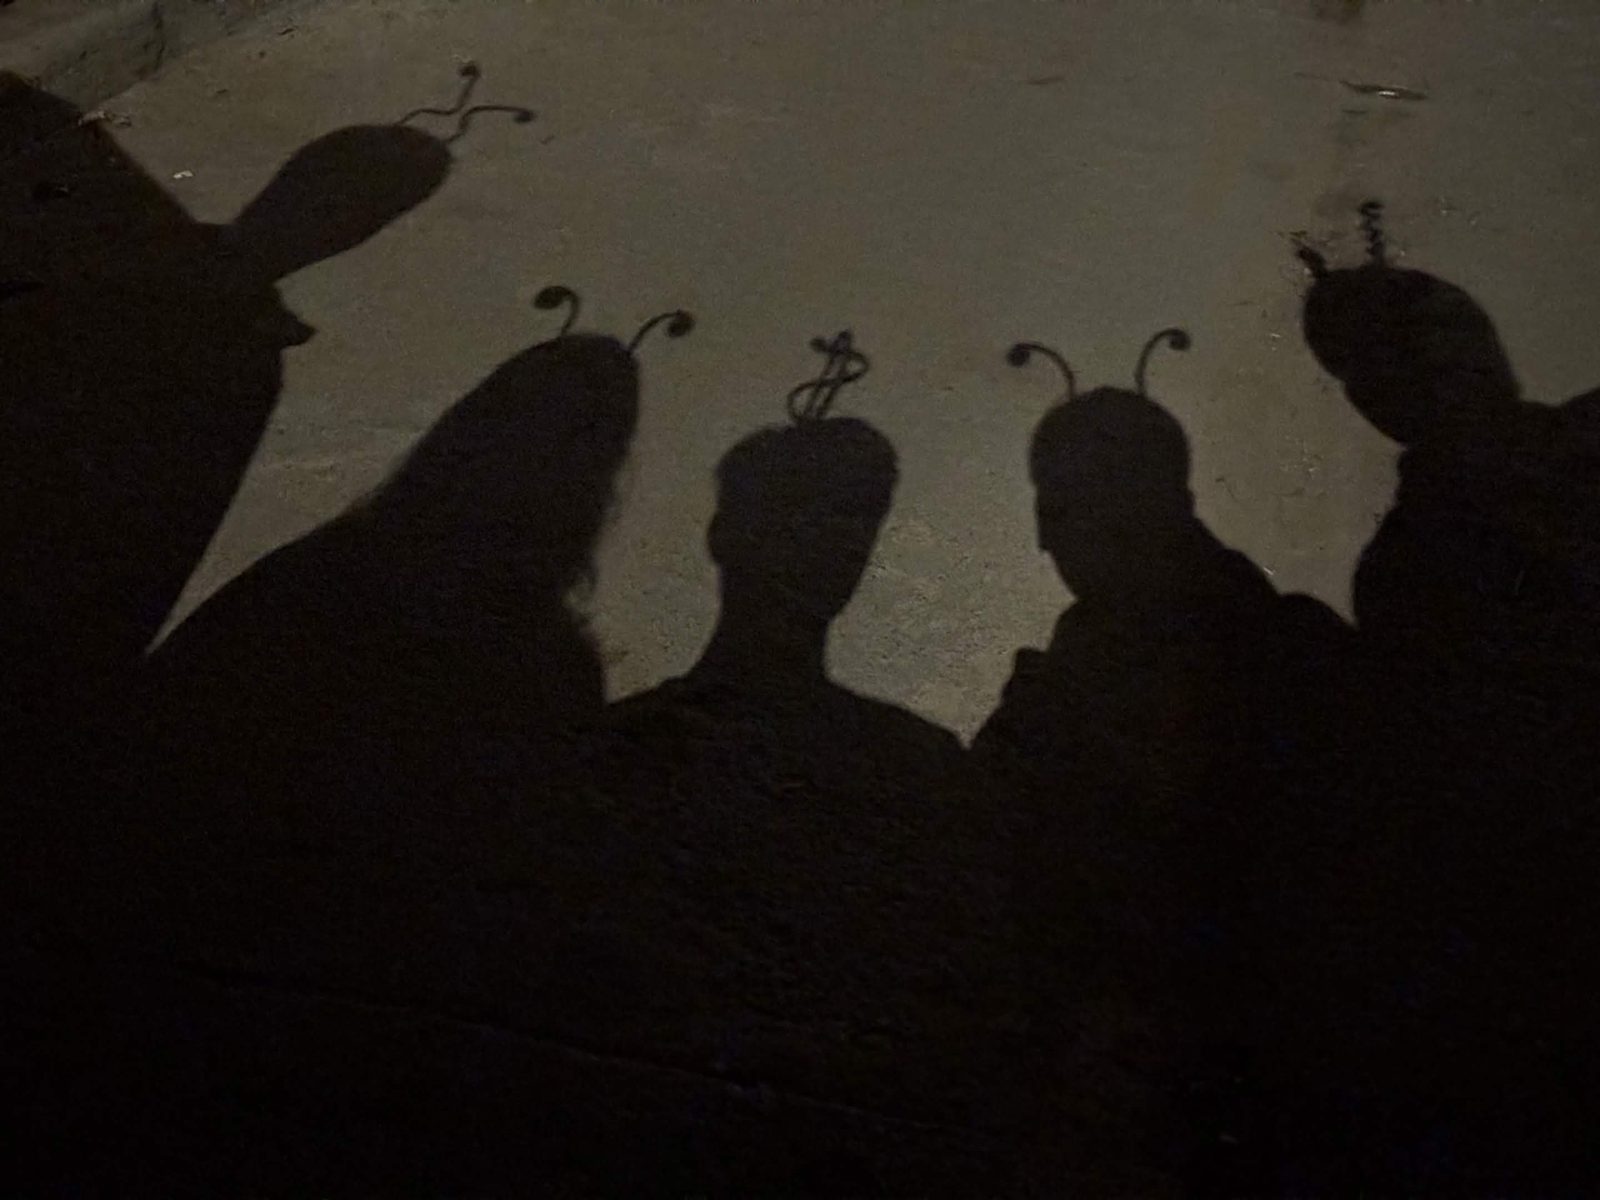
▚ 研究 ▞
音声と映像の同時生成
声と顔がひとつのモデルから生まれるため、本人らしさが途中でずれることはありません。私たちがJAM-Flowで最初に切り拓いた分野です。
リアルタイム人物動画生成
現時点でもっとも本人に忠実なリアルタイム人物動画生成。SoulX-LiveActは毎秒20フレームで人物を動かし、1時間崩れずに持続します。
高速な動画生成
蒸留、ガイダンス、サンプリング。拡散モデルをリアルタイムで動かせる速さにするための研究です。
拡散モデル内部での編集
凍結した拡散モデルの内部で行う編集。h-spaceの発見から、スタイルの制御、テロップの除去まで。
マルチモーダル知覚
2021年以降、被引用数は10,000を超え、ICLR、NeurIPS、CVPR、ECCVなどで100編以上の論文を発表。編集の前に、まずシーンを読む。どんな環境でも、映像と音声の両方から誰が話しているかを見分けます。


▚ 同じクリップで実測 ▞


出資元


- Stanford
- Yonsei